• Виктор
  • Блог
  • 2 мин. чтения

Tencent выпустила Hy Image 3.5 Preview для генерации и редактирования изображений


Tencent открыла доступ к Hy Image 3.5 Preview — модели, которая создаёт изображения по тексту и референсам, а затем правит результат в диалоге. Пользователь может уточнять композицию, стиль и отдельные детали без повторной генерации с нуля.

Модель появилась в сервисах Tencent и в облачном API. В релизных материалах компания заявляет генерацию изображений до 2K и цену $0,024 за изображение через международный Tencent Cloud API.

Если нужен доступ из России — эта и ещё три сотни моделей собраны в одном окне в сервисе Умка.

Что умеет Hy Image 3.5

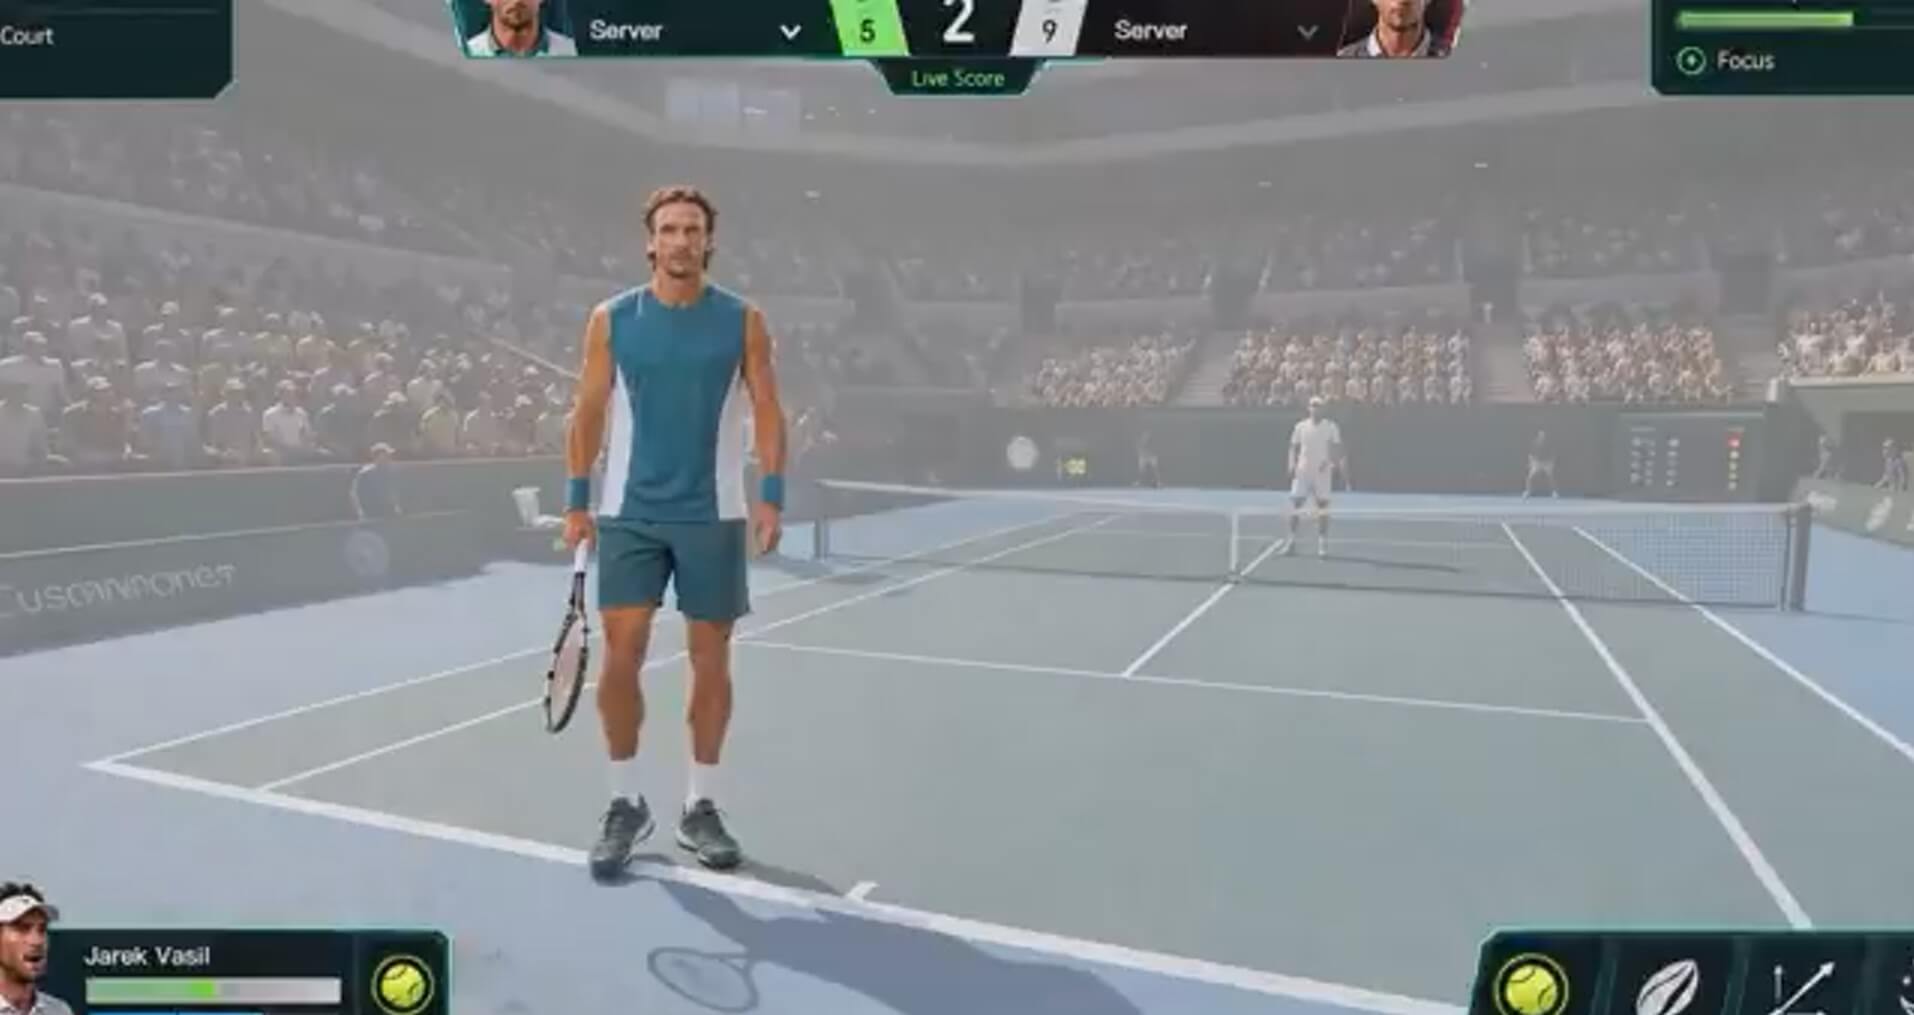
Модель работает в двух основных режимах: создаёт изображение по описанию или меняет загруженную картинку. За один запрос можно добавить до пяти референсов, чтобы передать внешний вид персонажа, предмета или визуального стиля.
Что умеет Hy Image 3.5

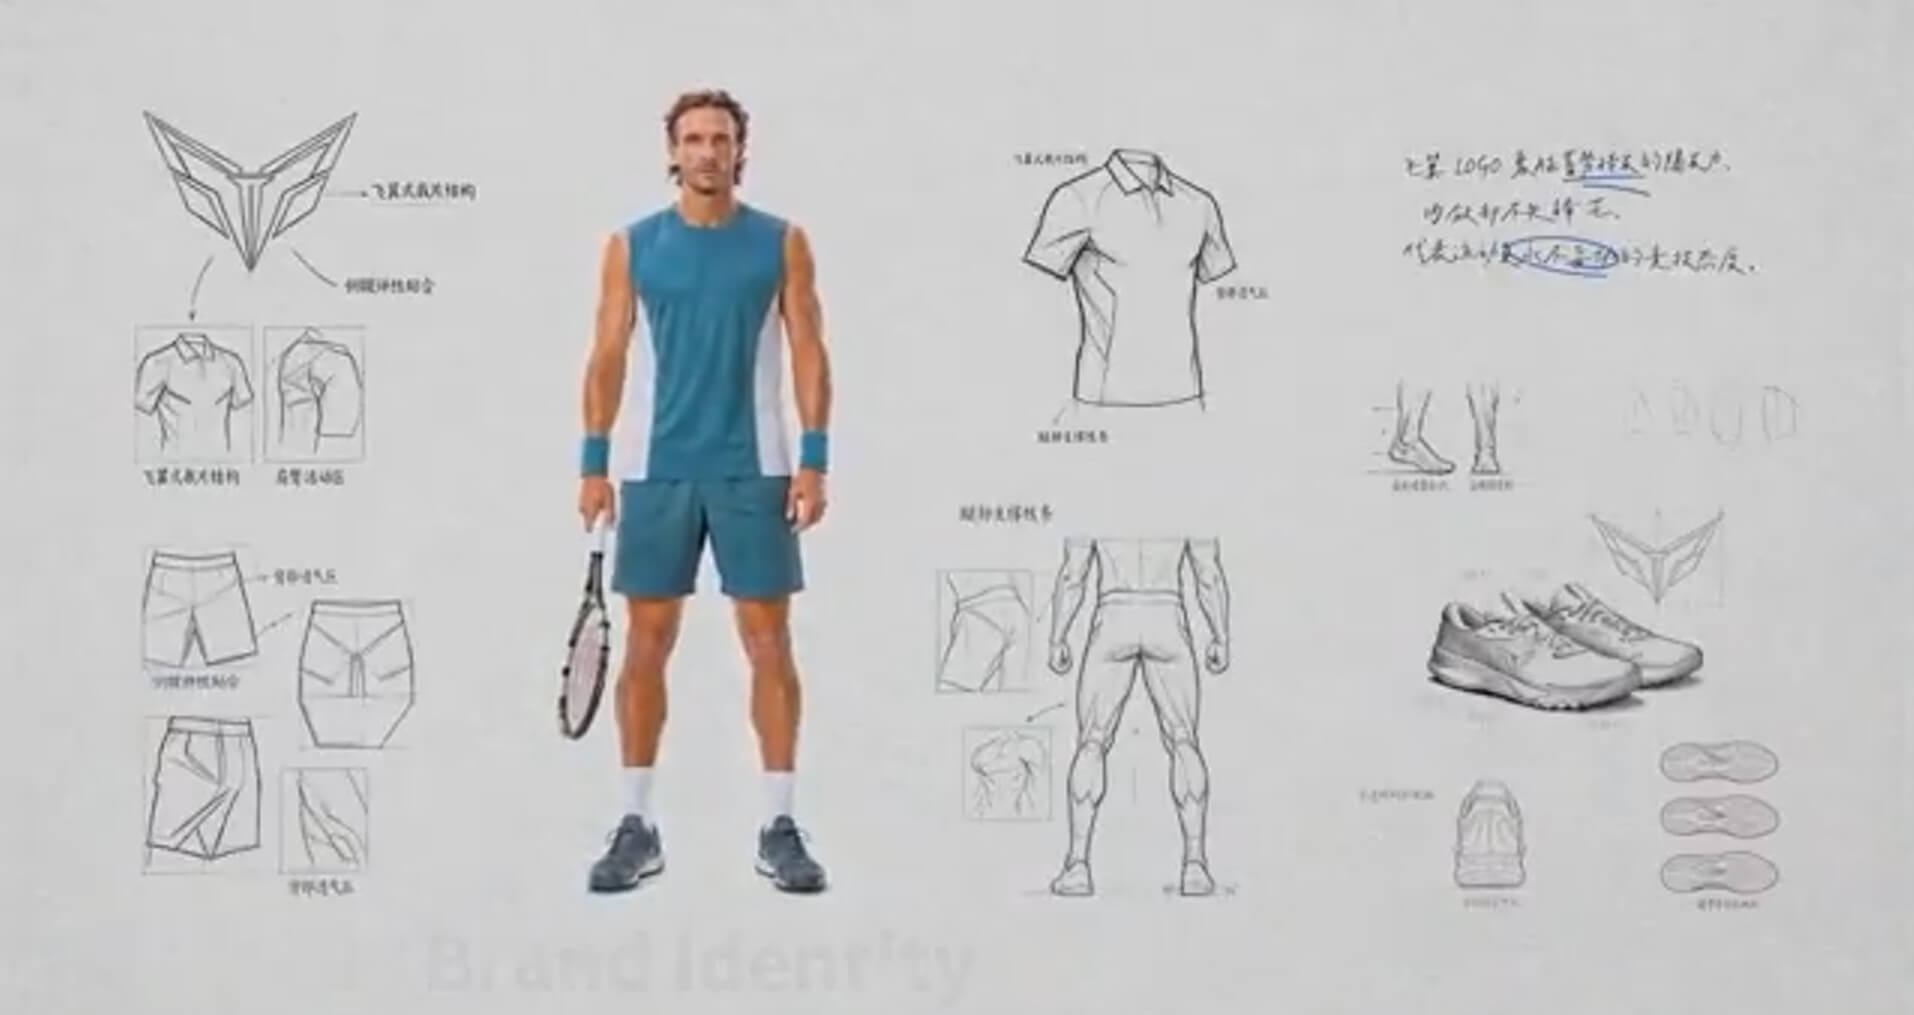
Hy Image 3.5 учитывает историю переписки. После первой генерации можно попросить заменить фон, исправить текст, изменить расположение объектов или продолжить правки в следующей реплике. Такой порядок подходит для рекламных макетов, карточек товаров, раскадровок и иллюстраций, где результат дорабатывают поэтапно.
Что умеет Hy Image 3.5

Tencent отдельно заявляет, что модель лучше воспроизводит надписи и макеты, сохраняет детали при редактировании и точнее следует запросу. Во внутреннем слепом тесте с участием профессиональных дизайнеров она получила примерно на 30% больше побед, чем Hy Image 3.0. Это результат теста самой компании, а не независимый рейтинг. Tencent также заявляет о сопоставимых результатах с Seedream 5.0 Pro и небольшом преимуществе над Nano-Banana Pro и Qwen-Image-3.0 Pro.

Где доступна модель

Hy Image 3.5 уже подключена к Yuanbao, ima, Miora, WorkRally, OnSolo и WorkBuddy. Через Tencent Cloud модель вызывается по идентификатору hy-image-v3.5-preview.

В публичном анонсе Tencent говорит о генерации до 2K. В документации TokenHub для API можно задать размер до 4096 × 4096 пикселей. Поэтому доступное разрешение зависит от сервиса и способа запуска модели.

Где доступна модель

Международный API стоит $0,024 за готовое изображение — оплачиваются только выходные изображения. Для работы через TokenHub нужны аккаунт Tencent Cloud, API-ключ и включённая постоплата.

Ранее Tencent открыла AuK — модель для генерации и редактирования речи по текстовой инструкции.

Изображения: x.com/TencentHunyuan/status/2102226552310419473


Источник

Где попробовать
Claude, GPT, Gemini и ещё 300 моделей — в одном окне
Умка даёт доступ к нейросетям на русском и за рубли: без VPN и зарубежных карт. Текст, картинки, видео и музыка — в одном интерфейсе. На пробу 60 токенов, карта не нужна.
Открыть Умку бесплатно
Межтекстовые Отзывы
Посмотреть все комментарии
guest

Обновление LTX Studio объединило генерацию, апскейл и цветокоррекцию

LTX Studio встроила редактирование изображений прямо в рабочее пространство проекта и тем самым сократила число лишних шагов при...

Нейросеть Veo 3.1: как пользоваться и создавать видео бесплатно

Google обновила свою модель для генерации видео — Veo 3.1, и теперь создание роликов со звуком и озвучкой...

Sakana Fugu: ИИ, который учится управлять другими ИИ

22 июня 2026 года японская лаборатория Sakana AI (Токио) представила свой новый коммерческий продукт под названием Sakana Fugu....

Yandex AI Studio позволит создавать ИИ-агентов на базе DeepSeek-V3.2

Yandex B2B Tech представила обновление Yandex AI Studio — платформы для разработки ИИ-приложений. Главное изменение: бизнес получил возможность...

Alibaba выпустила Qwen-Image 2.1 с генерацией прозрачных изображений

Команда Qwen выпустила Qwen-Image 2.1 — модель для генерации и редактирования изображений. Веса опубликованы 20 сентября 2026 года...

YouTube запустил генерацию видео с помощью Veo 2 для Shorts

YouTube представил новую функцию для генерации коротких роликов в Shorts, интегрировав ИИ-модель Veo 2 от Google в инструмент...

DeepSeek выпустила V4.1 Flash — открытую ИИ-модель с контекстом до 1 млн токенов

DeepSeek выпустила DeepSeek V4.1 Flash и открыла веса модели на Hugging Face. Она принимает текст и изображения, отвечает...

Google показала проекты на Gemini 3.8 Flash

Google показала четыре проекта, собранных разработчиками на Gemini 3.8 Flash. Модель вышла в начале сентября и, по заявлению...

Консистентность персонажей и стилей в нейросетях — что это и как сохранить

Представьте: вы потратили битый час на промт и наконец получили идеального персонажа. Делаете следующий шаг — просите его...

Luma Labs представила модель Uni-1 которая думает и рисует одновременно

Luma Labs представила Uni-1 - первую генеративную модель, которая объединяет мышление и создание изображений в одном процессе. Система...

Новые фишки и функции iOS 27 для iPhone — 13 главных обновлений

Недавно Apple выпустила iOS 27 — обновление доступно для iPhone 11 и более новых моделей, а также iPhone...

Suno вводит лимиты на скачивание — до 7 треков бесплатно

Suno объявила, что с 3 сентября введёт лимиты на скачивание созданной музыки. На бесплатном тарифе пользователи, зарегистрировавшиеся до...

История Starbucks: кто основал компанию, как появился логотип и кому принадлежит бренд

Сегодня Starbucks — одна из самых узнаваемых кофейных сетей мира: зелёную сирену знают даже те, кто ни разу...

Google анонсировала Pics — ИИ-редактор для работы с изображениями

Google анонсировала Pics — новый инструмент для генерации и редактирования изображений в Google Workspace. Он работает на базе...

Google довела ролики Gemini Omni до сорока секунд и сделала черновики втрое дешевле

Gemini Omni 1.1 Flash научилась достраивать снятую сцену продолжениями и доводить ролик до сорока секунд, а перед чистовой...

Google выпустила Nano Banana 2 Lite — быструю модель для генерации изображений через Gemini API

Google выпустила Nano Banana 2 Lite (gemini-3.1-flash-lite-image) — новую модель для генерации и редактирования изображений. Это самая быстрая...

ElevenLabs теперь можно подключить к Claude через MCP

ElevenLabs представила MCP-сервер для Claude. Он позволяет управлять агентами ElevenLabs из чата в Claude. Коннектор уже появился в...

ByteDance выпустила Seedream 4.0 — ИИ модель для генерации изображений, обгоняющую Nano Banana

ByteDance представила Seedream 4.0 — новую модель генерации и редактирования изображений, которая работает быстрее и стабильнее конкурентов. По...

ImagineArt запустила Ads Studio для генерации UGC-рекламы из ссылки на продукт

ImagineArt запустила Ads Studio - инструмент для генерации рекламных роликов из ссылки на товар. Сервис собирает UGC-видео, ролики...

Что изменилось в новой флагманской модели Anthropic Claude Opus 4.8

В мае 2026 года компания Anthropic обновила флагманскую модель Opus до версии 4.8. И на первый взгляд, этот...