
• Виктор
  • Блог
  • 3 мин. чтения

Google довела ролики Gemini Omni до сорока секунд и сделала черновики втрое дешевле


Gemini Omni 1.1 Flash научилась достраивать снятую сцену продолжениями и доводить ролик до сорока секунд, а перед чистовой генерацией показывать дешёвый черновик. 27 августа Google перевела модель в производственный статус и открыла её в Gemini API, Google AI Studio и Flow.

Google довела ролики Gemini Omni до сорока секунд и сделала черновики втрое дешевле

Gemini Omni 1.1 Flash — видеомодель Google для разработчиков, которую компания предлагает встраивать в редакторы и генераторы роликов. Обновление подаётся не как скачок в качестве картинки, а как набор рычагов управления: чем снимает виртуальная камера, что происходит между двумя кадрами, сколько длится сцена. Модель вышла из тестового статуса и работает в производственном режиме.

Сорок секунд из четырёх кусков

За одну генерацию Gemini Omni 1.1 Flash по-прежнему выдаёт десять секунд. Новое — возможность продолжить готовый фрагмент ещё одним десятисекундным куском, и так до сорока секунд общей длительности.

Опробовать её вместе с GPT, Claude и Gemini можно там же, где собраны нейросети на русском за рубли.

Работает это заметно аккуратнее прежнего. Раньше модель при продолжении смотрела только на последнюю секунду ролика, теперь берёт в расчёт до десяти секунд предыдущего материала. Именно на стыках генеративное видео обычно и рассыпается — герой меняет куртку, свет прыгает, интерьер перестраивается.

Ключевые кадры вместо длинных описаний

Второй рычаг — генерация по двум опорным кадрам. Разработчик задаёт первый и последний кадр, а Google достраивает то, что между ними: наезд, облёт объекта, разворот камеры, бесшовную петлю для фона. Сложные операторские движения вроде резкой панорамы или наезда с одновременным отъездом объектива модель отрабатывает по описанию.

К этому добавили визуальные референсы. На вход принимается до трёх видеофрагментов длиной до трёх секунд каждый — по ним модель удерживает внешность персонажа, стиль и вид товара. Раскадровка перестаёт быть текстовым упражнением, где нужную картинку выпрашивают формулировками.

Цена спустилась до уровня Alibaba

Для перебора вариантов появился режим 360p. Google обещает генерацию до 60% быстрее стандартного 720p и примерно треть его цены. Секунда 720p обходится около $0,10, считается она по токенам — 5792 токена на секунду ролика.

Про цену 1080p и 4K в анонсе не сказано ничего. Оба разрешения получаются апскейлом, тарифицируются те же токены, но во сколько раз дороже выйдет чистовик в 4K, компания отдельной строкой не показала. Для продукта, который продают студиям и редакторам, это неудобный пробел.
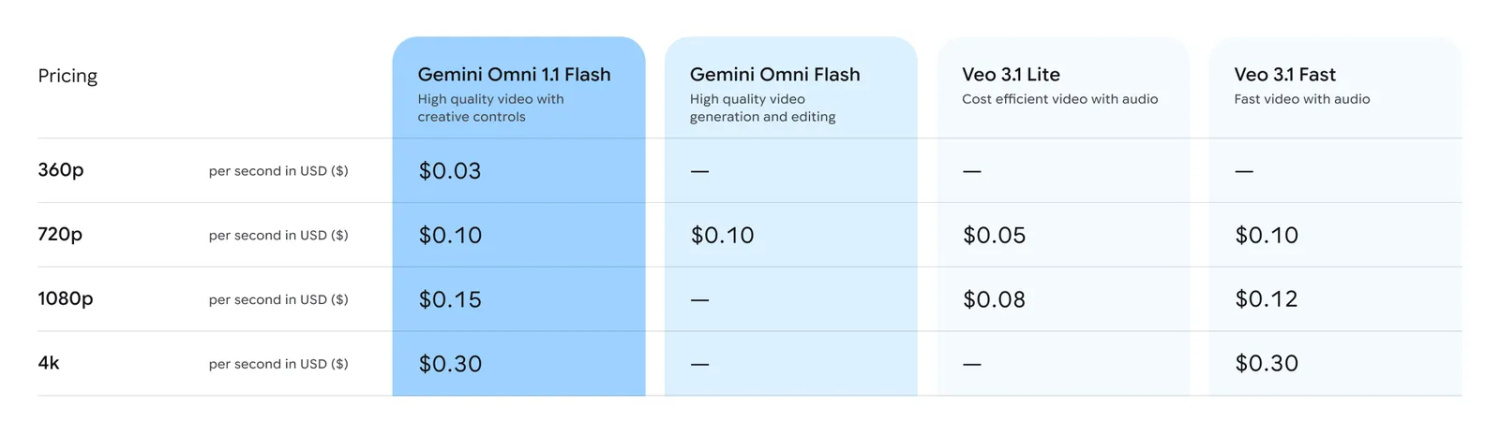
Цены

Google Veo 3.1 просит около $0,40 за секунду. Gemini Omni 1.1 Flash в стандартном качестве стоит вчетверо меньше и ровно столько же, сколько Alibaba берёт за 720p у Wan3.0, — ценовой паритет с китайским конкурентом Google держит впервые за год.

По длине ролика расклад другой. Wan3.0 выдаёт 30 секунд за одну генерацию без склейки, ByteDance в Seedance 2.5 — те же 30 секунд сразу в 4K. Сорок секунд Gemini Omni собираются из четырёх кусков, и это компромисс, а не рекорд. Зато поле Google освобождают сами конкуренты. Sora у OpenAI доживает последние недели, приложение закрыли ещё весной, API отключают в сентябре.

Лица и надписи всё ещё плывут

Слабые места Google не прячет. Согласованность персонажа при последовательных правках и текст в кадре остаются нерешёнными задачами — те же грабли, на которые публично наступила Alibaba с Wan3.0. Работа со звуком и речью придержана. Доступ к редактированию аудио Google открывает осторожно, пока обкатывает правила ответственного выпуска.

Потолок в сорок секунд тоже стоит держать в голове. Это четыре последовательных обращения к API, четыре точки, где сцена может уехать, и оплата каждой генерации отдельно.

Где включили и кто уже встроил

Разработчикам модель доступна в Google AI Studio и через Gemini API, корпоративным клиентам — через API платформы Gemini Enterprise. В Flow, видеоредакторе Google, она открыта подписчикам планов AI Plus, Pro и Ultra. Продолжение сцен добавили и в обычное приложение Gemini, там рычагов меньше, но попробовать механику можно без кода.

Из внешних продуктов модель уже подключили Adobe в Firefly, Figma в редакторе Weave и Runway , плюс несколько облачных провайдеров. Набор подобран под одну ставку. Google продаёт Gemini Omni тем, кто делает инструменты для монтажёров, а не конечному зрителю.

Черновики в 360p, чистовик в 1080p

Тем, кто делает ролики для сайтов и соцсетей, Gemini Omni 1.1 Flash меняет порядок работы. Идеи перебираются в 360p, пока не сойдётся композиция и движение камеры, и только потом оплачивается чистовая генерация. Черновой режим стоит треть обычного, поэтому десяток проб выходит дешевле одного неудачного финала.

Вторая привычка — короткие фоновые петли через первый и последний кадр. Одинаковые опорные кадры дают зацикленный ролик без видимого стыка, и такой фон в шапку страницы генерируется за секунды.

Гонка ушла из качества в управляемость

Заявку Gemini Omni 1.1 Flash стоит проверять на длинных сценах. Если четыре сшитых куска действительно держат лицо героя и свет, у рекламных студий пропадает главный довод против генеративного видео. Если на третьем стыке картинка поедет, сорок секунд останутся цифрой из пресс-релиза, а рабочим форматом — те же десять.

Источник

Где попробовать
Claude, GPT, Gemini и ещё 300 моделей — в одном окне
Умка даёт доступ к нейросетям на русском и за рубли: без VPN и зарубежных карт. Текст, картинки, видео и музыка — в одном интерфейсе. На пробу 60 токенов, карта не нужна.
Открыть Умку бесплатно
Межтекстовые Отзывы
Посмотреть все комментарии
guest

Nvidia «достигла AGI», но никто не знает, что это значит

В среду на отчётной конференции Nvidia Дженсен Хуанг заявил, что компания «достигла AGI» — искусственного общего интеллекта, одной...

Обновлённый Reve: свобода творчества без технических барьеров

Reve представила обновлённую платформу для генерации и редактирования изображений, стремясь сделать визуальное творчество доступным без технических барьеров. Новый...

Sora 2 увеличила длину видео до 25 секунд и позволила прописывать сценарий по кадрам

Компания OpenAI обновила видеогенератор «Sora 2»: базовые пользователи теперь могут создавать ролики до 15 секунд, а подписчики «ChatGPT...

Google запускает Nano Banana – новая эра редактирования изображений

Google представила модель искусственного интеллекта Nano Banana - предварительную версию Gemini 2.5 Flash Image, которая уже доступна пользователям...

Veo 3.1 уже доступна на WaveSpeedAI — создаёт видео из текста и картинок

Платформа WaveSpeedAI представила интеграцию с новой моделью Google Veo 3.1 — одной из самых продвинутых ИИ-моделей для генерации...

Google анонсировала Pics — ИИ-редактор для работы с изображениями

Google анонсировала Pics — новый инструмент для генерации и редактирования изображений в Google Workspace. Он работает на базе...

⚔️ Тестиум: ChatGPT или DeepSeek — кто лучше пишет тексты?

Привет! Меня зовут Анатолий Чупин. Я редактор сайта Postium, исследователь ИИ и автор Telegram-канала «Промты — и точка»....

GLM 5.3: мощнее в коде и кибербезопасности

14 августа 2026 года уже упоминавшаяся нами в предыдущих обзорах компания Zhipu AI представила следующую версию своей флагманской...

OpenAI уберёт GPT-5.5 из ChatGPT и Codex 14 октября

OpenAI предупредила о завершении поддержки GPT-5.5 в ChatGPT, ChatGPT Work и Codex. Модель уберут из этих продуктов 14...

В Gemini появились цифровые аватары для Nano Banana

Google добавила в Gemini персональные аватары. Теперь можно один раз записать лицо и голос, после чего создавать изображения...

DeepSeek представила DeepSeek-OCR — новую модель для сжатия визуального контекста в LLM

Компания DeepSeek показала DeepSeek-OCR — OCR-модель, созданную специально для больших языковых моделей. Вместо обычного распознавания текста она сжимает...

Runway представила Multi-Shot App: от одного промпта к полноценной многосценной истории с диалогами, звуком и монтажом

Runway представила новый инструмент, который заметно упрощает создание видеоконтента с помощью нейросетей. Multi-Shot App превращает один текстовый запрос...

Консистентность персонажей и стилей в нейросетях — что это и как сохранить

Представьте: вы потратили битый час на промт и наконец получили идеального персонажа. Делаете следующий шаг — просите его...

Yandex AI Studio позволит создавать ИИ-агентов на базе DeepSeek-V3.2

Yandex B2B Tech представила обновление Yandex AI Studio — платформы для разработки ИИ-приложений. Главное изменение: бизнес получил возможность...

Qwen выпустила Qwen-Image-3.0 — модель генерирует сложные макеты и текст от 10 пикселей

Qwen представила Qwen-Image-3.0 — третье поколение модели для генерации и редактирования изображений. Она принимает инструкции объёмом до 4,5...

Grok 4.7 обогнал более дорогих конкурентов в юридических задачах

SpaceXAI выпустила Grok 4.7 - флагманскую модель для программирования и долгой рабочей рутины. Она заметно прибавила против Grok...

Стал известен размер экрана iPhone 20 Pro и Pro Max

В сети появились первые подробности об экранах iPhone 20 Pro и iPhone 20 Pro Max. По данным инсайдера...

Промты для фото и открыток ко Дню России, +нейросети для генерации

Ищете промты для открыток ко Дню России? Нейросети могут сделать семейное поздравление по фото, портрет в праздничном образе,...

ElevenLabs представила Studio 4.0 с генерацией видео, изображений и звука

ElevenLabs выпустила Studio 4.0 — обновлённый редактор, а также Studio Agent. В одном проекте теперь можно генерировать видео,...

Razer выпустила одноручный кейпад Tartarus V2 Pro

Razer начала продажи Tartarus V2 Pro — одноручного игрового кейпада с 31 программируемым элементом управления. Устройство рассчитано на...