• Виктор
  • Блог
  • 2 мин. чтения

DeepSeek представила DeepSeek-OCR — новую модель для сжатия визуального контекста в LLM


Компания DeepSeek показала DeepSeek-OCR — OCR-модель, созданную специально для больших языковых моделей. Вместо обычного распознавания текста она сжимает страницу в визуальные токены, чтобы LLM могла читать документы быстрее и дешевле.

На vLLM 0.8.5 модель выдаёт около 2500 токенов в секунду на GPU A100-40G. Postium собрал ключевые детали о новинке.

DeepSeek-OCR — что это и как работает

DeepSeek-OCR — новая система распознавания текста от компании DeepSeek, созданная специально для работы с большими языковыми моделями (LLM).

Главная идея — не просто превращать изображение в текст, а сжимать визуальный контекст страницы (документа, PDF) в компактный набор токенов, которые LLM потом «распаковывает» и понимает.

Как это работает:

  1. Страница превращается в визуальные токены. Модель анализирует изображение (скан, PDF) и кодирует его в десятки, а не тысячи токенов.
  2. LLM получает компактное представление. Эти токены уже содержат информацию о тексте, структуре (таблицы, списки) и формате документа.
  3. Распаковка и понимание. Внутри LLM эти токены преобразуются обратно в текст и структуру — без необходимости видеть каждый пиксель.

Результат — LLM понимает документ целиком, но тратит в 10–20 раз меньше контекста, чем при обычном OCR.

На бенчмарке OmniDocBench DeepSeek-OCR опережает GOT-OCR 2.0 и MinerU 2.0, используя при этом в 2–3 раза меньше визуальных токенов.
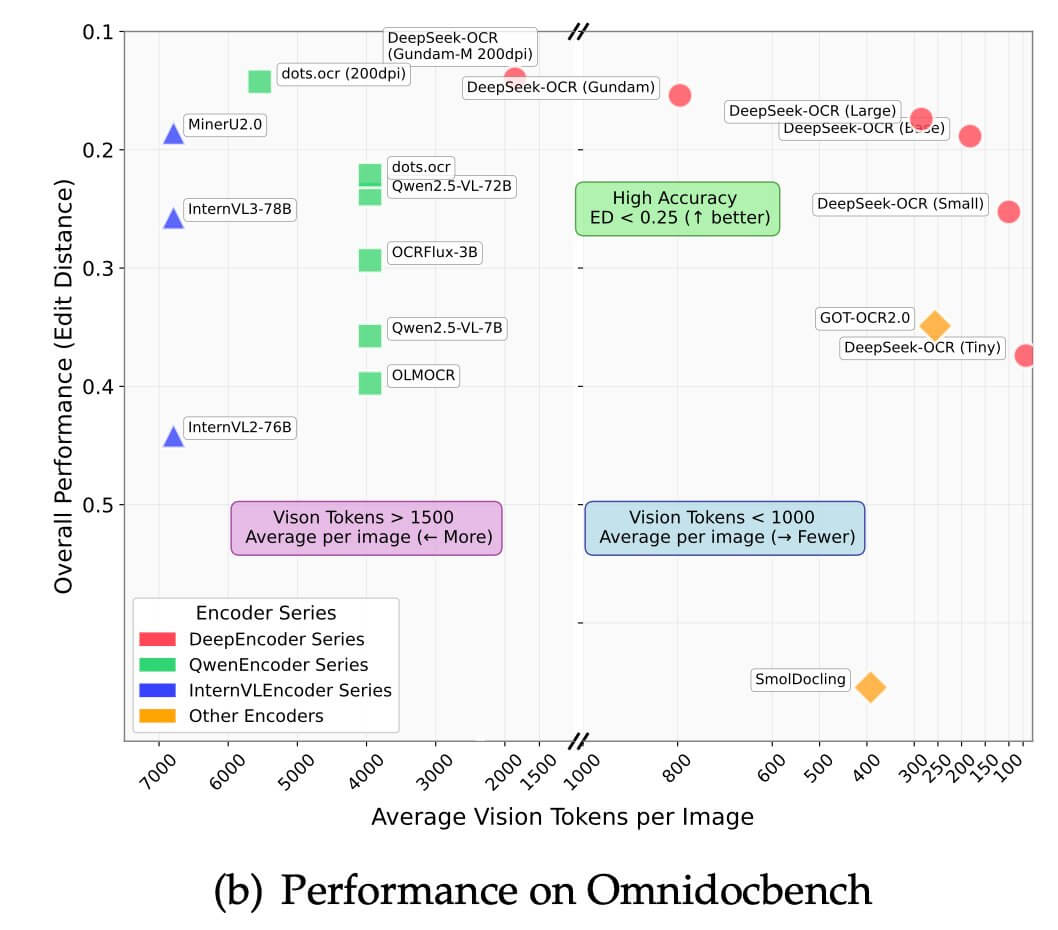
Почему это важно: DeepSeek-OCR делает работу LLM с документами быстрее — до 2500 токенов/с на GPU A100, дешевле — за счёт меньшего числа токенов при инференсе, точнее — сохраняя 97% точности при 10-кратном сжатии, и гибче — поддерживая PDF, сканы и изображения напрямую через vLLM.

Где может применяться:

  • Автоматический разбор контрактов, отчётов, форм;
  • Быстрое извлечение данных из длинных PDF;
  • Подготовка структурированных ответов (JSON, Markdown, таблицы);
  • Встраивание в RAG-пайплайны и чат-ботов с документами.

Как пользоваться? DeepSeek-OCR — инструмент для разработчиков, а не конечных пользователей. Модель можно скачать с Hugging Face или GitHub и встроить в свои пайплайны — например, в веб-сервисы, системы анализа документов или обработку больших данных.

Она принимает на вход изображения, сканы и PDF-страницы, возвращая компактные визуальные токены или распознанный текст. Совместима с vLLM 0.8.5, Transformers, PyTorch 2.6+ и работает на CUDA 11.8+.

Итог: DeepSeek-OCR не делает ИИ «зрячим» в человеческом смысле, но приближает его к тому, как человек воспринимает документ.

Раньше OCR видел только буквы и строки, не понимая, где таблица, где подпись, а где заголовок. Теперь модель передаёт LLM сжатое, но осмысленное представление страницы — так, как человек видит её целиком: и текст, и структуру, и логику оформления.

Также, недавно стало известно, что DeepSeek V4 может выйти в октябре.


Источник

Где попробовать
Claude, GPT, Gemini и ещё 300 моделей — в одном окне
Умка даёт доступ к нейросетям на русском и за рубли: без VPN и зарубежных карт. Текст, картинки, видео и музыка — в одном интерфейсе. На пробу 60 токенов, карта не нужна.
Открыть Умку бесплатно
Межтекстовые Отзывы
Посмотреть все комментарии
guest

Kimi управляет сайтами из боковой панели Chrome и запоминает действия

Kimi теперь открывает сайты, нажимает кнопки и заполняет формы по просьбе, написанной в чате. Moonshot AI переименовала своё...

Как пользоваться Nano Banana 2 Lite бесплатно — гайд

Недавно Google выпустил нейросеть Nano Banana 2 Lite — облегчённую версию генератора изображений на базе Gemini. ИИ-модель быстро...

ElevenLabs запустила Flows Agent в ElevenCreative — агент строит workflow по текстовому запросу

ElevenLabs представила Flows Agent в ElevenCreative. Пользователь описывает, что хочет создать, а ИИ-агент подбирает модели, добавляет узлы на...

Промты для создания стикеров по фото в ChatGPT, +лучшие ИИ для стикеров

С помощью ИИ теперь можно за несколько минут сделать собственный набор стикеров для Telegram, Discord или соцсетей —...

Лимиты использования в ChatGPT/Codex: где посмотреть и как сбросить

Даже на платных тарифах ChatGPT действуют лимиты на использование. Если они заканчиваются, сервис может прямо во время работы...

Perplexity Computer научилась создавать видео для кампаний и соцсетей

Perplexity добавила генерацию видео в ИИ-агента Computer. Сервис использует модели MiniMax H3 и ByteDance Seedance 2.5 и может...

Synthesia встроила агента в редактор и обновила модель аватаров

Synthesia запустила Assistant - чат-агента, который собирает ролик из промпта, документа или ссылки прямо в редакторе и правит...

Luma Labs представила модель Uni-1 которая думает и рисует одновременно

Luma Labs представила Uni-1 - первую генеративную модель, которая объединяет мышление и создание изображений в одном процессе. Система...

Нейросеть Sora 2: как пользоваться, где взять инвайт, возможности, как скачать

OpenAI представила Sora 2 — новую версию своей видеомодели, которая автоматически генерирует короткие ролики со звуком и синхронной...

Нейросеть для сложных расчётов: чек-лист для новичка

Недавно нейросеть Claude посчитала физическую задачу, с которой годами возились специалисты — расчёт на девять петель в квантовой...

ByteDance открыла публичный API Seedance 2.5

7 августа Volcano Engine открыла публичный API Seedance 2.5 - видеомодели ByteDance, которая одним проходом собирает 30-секундный ролик...

OpenAI выпустила приложение Sora на Android — пока только в 7 странах

OpenAI представила Android-версию приложения Sora — инструмента для генерации коротких видео с помощью искусственного интеллекта. Скачать ИИ-генератор видео...

NotebookLM научился делать минутные вертикальные видео из документов

Google добавила в NotebookLM новый формат - Short Video Overviews. Сервис автоматически собирает из загруженных документов короткое вертикальное...

PixVerse обновила партнёрскую программу для авторов AI-видео

PixVerse представила Global Creative Partner Program 2.0 - обновлённую партнёрскую программу для авторов AI-видео. Участникам обещают кредиты, денежные...

ElevenLabs добавила генерацию речи, музыки, изображений и видео в MCP

ElevenLabs расширила свой MCP-сервер. Теперь подключённый ИИ-ассистент может создавать речь, музыку, звуковые эффекты, изображения и видео, а также...

OpenAI снова столкнулась с неконтролируемым поведением ИИ-агентов

OpenAI оказалась в центре ещё одного инцидента с роем ИИ-агентов. По словам исследователей, внутренние агенты компании в мае...

Perplexity встроила слайдер вычислительных усилий в агентный сервис Computer

Perplexity добавила слайдер управления вычислительными усилиями в агентный сервис Computer. Пользователи веб-версии платформы могут выбирать глубину рассуждений и...

GLM 5.2. Мощная модель в открытом доступе

Китайская компания Zhipu AI, которая на международном рынке работает под именем Z.ai, этим летом выпустила новую большую языковую...

Скоро выйдет Veo 3.1? Обещают стабильных персонажей и киношные пресеты

На платформе WaveSpeedAI появился тизер будущего релиза Google Veo 3.1. Судя по описанию, новое поколение видеомодели решит главную...

Маркетолог PRO от MTC ADS: отзывы и возможности сервиса для запуска бизнес-рекламы в Telegram

Результативность рекламной кампании зависит от десятков, даже сотен факторов. Один из основных критериев — определение целевой аудитории и...