• Виктор
  • Блог
  • 2 мин. чтения

DeepSeek представила DeepSeek-OCR — новую модель для сжатия визуального контекста в LLM


Компания DeepSeek показала DeepSeek-OCR — OCR-модель, созданную специально для больших языковых моделей. Вместо обычного распознавания текста она сжимает страницу в визуальные токены, чтобы LLM могла читать документы быстрее и дешевле.

На vLLM 0.8.5 модель выдаёт около 2500 токенов в секунду на GPU A100-40G. Postium собрал ключевые детали о новинке.

DeepSeek-OCR — что это и как работает

DeepSeek-OCR — новая система распознавания текста от компании DeepSeek, созданная специально для работы с большими языковыми моделями (LLM).

Главная идея — не просто превращать изображение в текст, а сжимать визуальный контекст страницы (документа, PDF) в компактный набор токенов, которые LLM потом «распаковывает» и понимает.

Как это работает:

  1. Страница превращается в визуальные токены. Модель анализирует изображение (скан, PDF) и кодирует его в десятки, а не тысячи токенов.
  2. LLM получает компактное представление. Эти токены уже содержат информацию о тексте, структуре (таблицы, списки) и формате документа.
  3. Распаковка и понимание. Внутри LLM эти токены преобразуются обратно в текст и структуру — без необходимости видеть каждый пиксель.

Результат — LLM понимает документ целиком, но тратит в 10–20 раз меньше контекста, чем при обычном OCR.

На бенчмарке OmniDocBench DeepSeek-OCR опережает GOT-OCR 2.0 и MinerU 2.0, используя при этом в 2–3 раза меньше визуальных токенов.
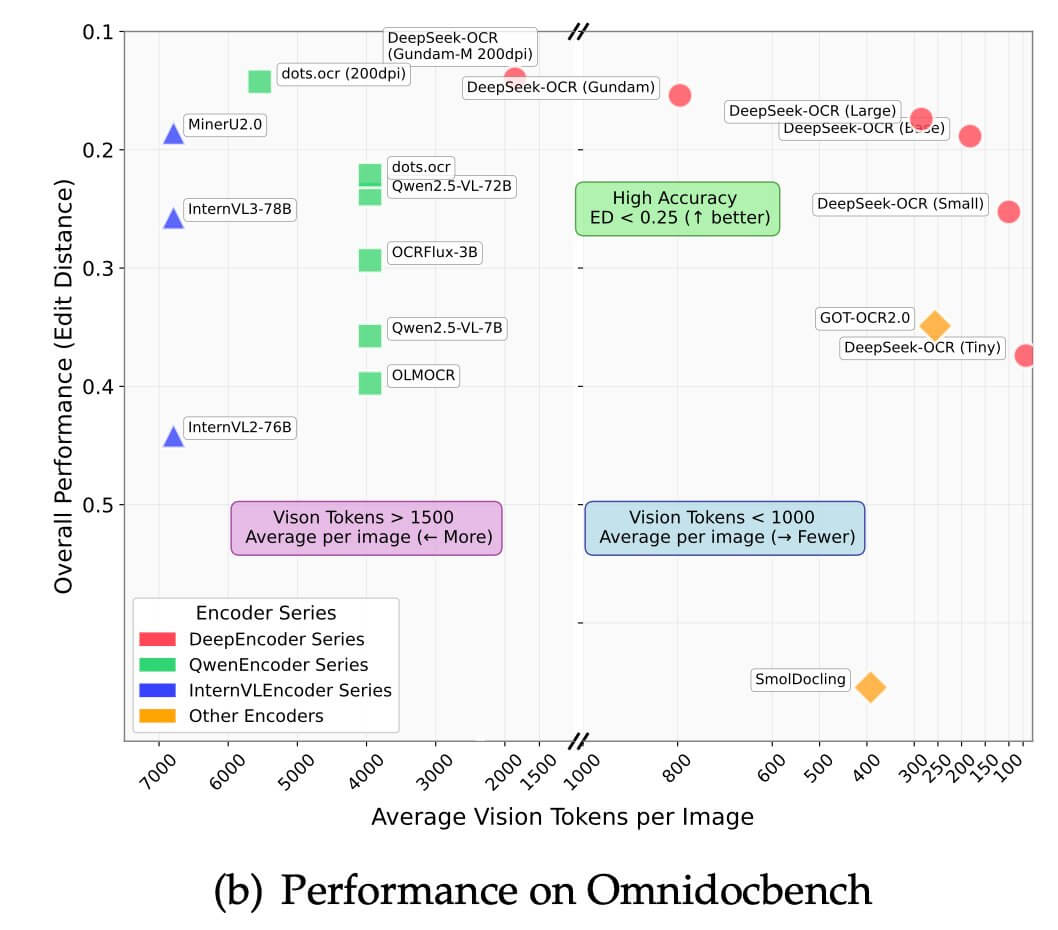
Почему это важно: DeepSeek-OCR делает работу LLM с документами быстрее — до 2500 токенов/с на GPU A100, дешевле — за счёт меньшего числа токенов при инференсе, точнее — сохраняя 97% точности при 10-кратном сжатии, и гибче — поддерживая PDF, сканы и изображения напрямую через vLLM.

Где может применяться:

  • Автоматический разбор контрактов, отчётов, форм;
  • Быстрое извлечение данных из длинных PDF;
  • Подготовка структурированных ответов (JSON, Markdown, таблицы);
  • Встраивание в RAG-пайплайны и чат-ботов с документами.

Как пользоваться? DeepSeek-OCR — инструмент для разработчиков, а не конечных пользователей. Модель можно скачать с Hugging Face или GitHub и встроить в свои пайплайны — например, в веб-сервисы, системы анализа документов или обработку больших данных.

Она принимает на вход изображения, сканы и PDF-страницы, возвращая компактные визуальные токены или распознанный текст. Совместима с vLLM 0.8.5, Transformers, PyTorch 2.6+ и работает на CUDA 11.8+.

Итог: DeepSeek-OCR не делает ИИ «зрячим» в человеческом смысле, но приближает его к тому, как человек воспринимает документ.

Раньше OCR видел только буквы и строки, не понимая, где таблица, где подпись, а где заголовок. Теперь модель передаёт LLM сжатое, но осмысленное представление страницы — так, как человек видит её целиком: и текст, и структуру, и логику оформления.

Также, недавно стало известно, что DeepSeek V4 может выйти в октябре.


Источник

Где попробовать
Claude, GPT, Gemini и ещё 300 моделей — в одном окне
Умка даёт доступ к нейросетям на русском и за рубли: без VPN и зарубежных карт. Текст, картинки, видео и музыка — в одном интерфейсе. На пробу 60 токенов, карта не нужна.
Открыть Умку бесплатно
Межтекстовые Отзывы
Посмотреть все комментарии
guest

Qwen выпустила Qwen-Image-3.0 — модель генерирует сложные макеты и текст от 10 пикселей

Qwen представила Qwen-Image-3.0 — третье поколение модели для генерации и редактирования изображений. Она принимает инструкции объёмом до 4,5...

NotebookLM научился делать минутные вертикальные видео из документов

Google добавила в NotebookLM новый формат - Short Video Overviews. Сервис автоматически собирает из загруженных документов короткое вертикальное...

Alibaba выпустила Qwen-Image 2.1 с генерацией прозрачных изображений

Команда Qwen выпустила Qwen-Image 2.1 — модель для генерации и редактирования изображений. Веса опубликованы 20 сентября 2026 года...

MiniMax выпустила видеомодель H3 – ролики в 2K со звуком

MiniMax 31 июля представила H3 - мультимодальную видеомодель, которая принимает текст, изображения, видео и звук и выдаёт ролики...

OpenAI стандартизировала отчёты об отклонениях и скрытом поведении ИИ-моделей

OpenAI представила фреймворк для отчётов о рассогласовании моделей (Model Misalignment Reporting Framework). Компания стандартизировала сбор данных об опасных...

Perplexity встроила слайдер вычислительных усилий в агентный сервис Computer

Perplexity добавила слайдер управления вычислительными усилиями в агентный сервис Computer. Пользователи веб-версии платформы могут выбирать глубину рассуждений и...

Grok 4.7 обогнал более дорогих конкурентов в юридических задачах

SpaceXAI выпустила Grok 4.7 - флагманскую модель для программирования и долгой рабочей рутины. Она заметно прибавила против Grok...

OpenAI представила GPT 5.6. Три модели, новые агенты и снижение цен

Летом 2026 года компания OpenAI представила свое новое семейство моделей под общим названием GPT 5.6. Релиз получился довольно...

ElevenLabs выпустили Eleven v4 и v4 Turbo — ИИ для озвучки с управлением эмоциями и манерой речи

ElevenLabs представила новые модели синтеза речи Eleven v4 и Eleven v4 Turbo. Они построены на новой архитектуре и...

Вышел Kling O1 — рассуждающая нейросеть для генерации и редактирования видео

Kling AI выпустила новую ИИ-модель Kling O1 (Omni One). Это рассуждающая нейросеть, которая генерирует видео по тексту и...

Как пользоваться Nano Banana 2 Lite бесплатно — гайд

Недавно Google выпустил нейросеть Nano Banana 2 Lite — облегчённую версию генератора изображений на базе Gemini. ИИ-модель быстро...

Нейросеть Кандинский 3.0: как пользоваться, как обрабатывать фото и создавать картинки

Кандинский – это бесплатная нейросеть от Сбера, способная генерировать картинки по текстовому описанию. Работает по сходному с Midjourney...

Промты для новогодней ИИ-фотосессии, +подходящие нейросети

Как говорят, готовь сани зимой, а промты для новогодних ИИ-фотосессий — в ноябре. Картинки можно публиковать уже сейчас...

Pika Labs запустила Pika Agents

Pika Labs вывела Pika Agents в открытый доступ и предложила другой способ работы с генеративным ИИ. Вместо привычного...

OpenAI сняла лимиты на текстовые чаты в ChatGPT для всех пользователей

OpenAI объявила об отмене лимитов на текстовые чаты для всех пользователей ChatGPT. Сервис, по данным компании, недавно преодолел...

ByteDance выпустила Seedream 5.0 Pro для инфографики и точного редактирования изображений

ByteDance Seed 8 июля 2026 года представила Seedream 5.0 Pro - мультимодальную модель для генерации и редактирования изображений....

Midjourney V8.1 ускорилась и вернула стиль

Midjourney выпустила альфа-версию V8.1, в которой разработчики сделали ставку на баланс: вернули фирменный визуальный стиль, ускорили генерацию и...

15 главных сериалов октября 2026 года, которые нельзя пропустить

Октябрь — самое время доставать плед, заваривать что-нибудь горячее и устраивать длинные вечера за просмотром сериалов. Тем более...

Новое поколение DLSS 5 от NVIDIA: революционный ИИ-рендеринг выйдет 3 сентября

Компания NVIDIA официально анонсировала технологию DLSS 5, запуск которой запланирован на 3 сентября 2026 года. Первой игрой с...

Как пользоваться QwenWork: регистрация, возможности, бесплатные кредиты и тарифы

QwenWork — это новый ИИ-агент от Alibaba, который доступен на сайте и через отдельное приложение. По принципу работы...