• Виктор
  • Блог
  • 2 мин. чтения

ElevenLabs выпустили Eleven v4 и v4 Turbo — ИИ для озвучки с управлением эмоциями и манерой речи


ElevenLabs представила новые модели синтеза речи Eleven v4 и Eleven v4 Turbo. Они построены на новой архитектуре и рассчитаны на создание более выразительной озвучки с управлением эмоциями, темпом и манерой подачи прямо в тексте.

Eleven v4 создавали специально для контента, аудиокниг, озвучки персонажей и других сценариев, где важнее всего качество. Версия v4 Turbo сохраняет выразительность основной модели, но оптимизирована для работы в реальном времени — в частности, с голосовыми агентами. По данным ElevenLabs, её медианная задержка инференса составляет около 100 мс, а время до первого звука — около 150 мс.

Нейросеть Eleven v4: что умеет и как работает

Одно из ключевых изменений — более точное управление подачей. В текст можно добавлять аудиотеги вроде [whispering], [shouting], [laughing], [sigh] и задавать, как должна звучать конкретная реплика. Модель также учитывает контекст сцены, поэтому может менять эмоциональную подачу в рамках одного текста. ElevenLabs отмечает, что v4 надёжнее следует последовательностям тегов, чем предыдущая версия.
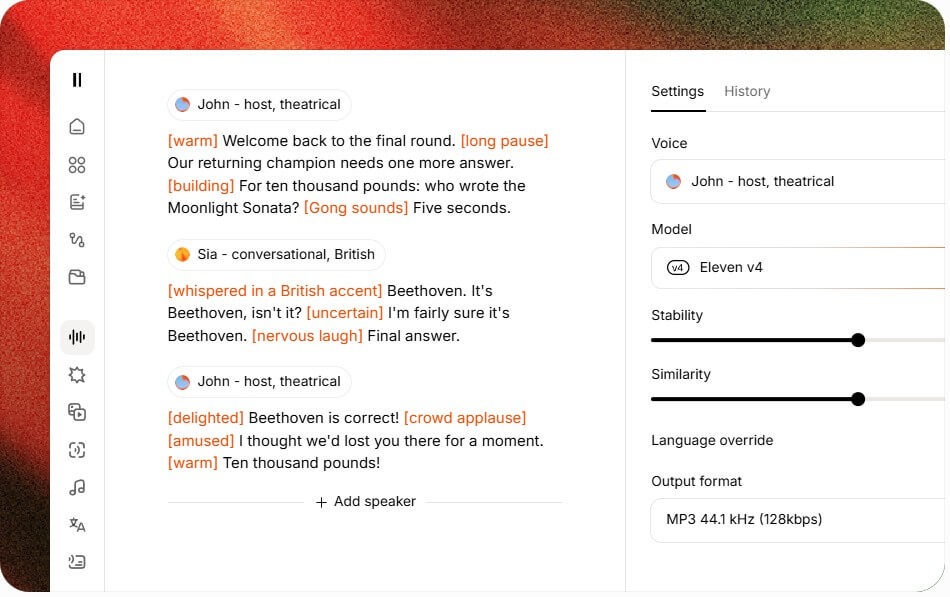
Для длинных материалов используется контекстное сшивание: оно помогает сохранять темп и характер подачи между отдельными генерациями. Компания также заявляет, что голос остаётся стабильным при повторной генерации отдельных фрагментов, что упрощает работу с диалогами и длинной озвучкой.

Клонирование голоса и языки

Eleven v4 поддерживает Instant Voice Cloning — голос можно клонировать по записи длительностью от 10 секунд. Также модель снова поддерживает Professional Voice Clones, которые рассчитаны на более точное воспроизведение исходного голоса. Для использования клона требуется подтверждённое согласие владельца голоса.

Модель работает более чем с 90 языками, включая русский. ElevenLabs отдельно указывает, что v4 может генерировать речь на поддерживаемых языках с одним и тем же голосом.

Eleven v4 и v4 Turbo доступны через ElevenCreative, ElevenAgents и ElevenAPI. Для API предусмотрены как потоковая, так и обычная генерация речи.

Ранее ElevenLabs представила Studio 4.0 с генерацией видео, изображений и звука.

Изображения: elevenlabs.io


Источник

Где попробовать
Claude, GPT, Gemini и ещё 300 моделей — в одном окне
Умка даёт доступ к нейросетям на русском и за рубли: без VPN и зарубежных карт. Текст, картинки, видео и музыка — в одном интерфейсе. На пробу 60 токенов, карта не нужна.
Открыть Умку бесплатно
Межтекстовые Отзывы
Посмотреть все комментарии
guest

Veo 3.1 уже доступна на WaveSpeedAI — создаёт видео из текста и картинок

Платформа WaveSpeedAI представила интеграцию с новой моделью Google Veo 3.1 — одной из самых продвинутых ИИ-моделей для генерации...

Runway представила Multi-Shot App: от одного промпта к полноценной многосценной истории с диалогами, звуком и монтажом

Runway представила новый инструмент, который заметно упрощает создание видеоконтента с помощью нейросетей. Multi-Shot App превращает один текстовый запрос...

Обновление LTX Studio объединило генерацию, апскейл и цветокоррекцию

LTX Studio встроила редактирование изображений прямо в рабочее пространство проекта и тем самым сократила число лишних шагов при...

Alibaba выпустила Qwen-Image 2.1 с генерацией прозрачных изображений

Команда Qwen выпустила Qwen-Image 2.1 — модель для генерации и редактирования изображений. Веса опубликованы 20 сентября 2026 года...

Поздравление с ИИ: что бесплатно, а что платно в 2026

Каждый раз, когда у кого-то из близких день рождения, встаёт один и тот же вопрос: написать обычное «с...

Как пользоваться QwenWork: регистрация, возможности, бесплатные кредиты и тарифы

QwenWork — это новый ИИ-агент от Alibaba, который доступен на сайте и через отдельное приложение. По принципу работы...

Alibaba выпустила Qwen-Image-3.0 без весов и бенчмарков, но с промптами на 4500 токенов

Alibaba выпустила Qwen-Image-3.0 - третье поколение генератора изображений с прицелом на практическую пользу: длинные детальные подписи, читаемый мелкий...

Скоро выйдет Veo 3.1? Обещают стабильных персонажей и киношные пресеты

На платформе WaveSpeedAI появился тизер будущего релиза Google Veo 3.1. Судя по описанию, новое поколение видеомодели решит главную...

Яндекс сводит аналитику данных в одну платформу

Yandex B2B Tech анонсировала DataLens Platform, платформу для работы с корпоративными данными от загрузки и хранения до отчётов...

Подписка на Suno AI: тарифы, как купить из России и сколько стоит трек

Если вы открыли эту статью, то, скорее всего, уже знакомы с Suno AI: знаете, как работает нейросеть, и...

Alibaba сообщила о падении прибыли на 75% из-за крупных инвестиций в ИИ-инфраструктуру

Китайский технологический гигант Alibaba в четверг сообщил о падении прибыли за последний квартал на 75% на фоне крупных...

ComfyUI заморозила новые бесплатные аккаунты в Comfy Cloud из-за злоупотреблений видеомоделями

ComfyUI временно остановила создание новых бесплатных аккаунтов в Comfy Cloud. Причина - инцидент со злоупотреблениями, в котором атаковали...

Промты для новогодней ИИ-фотосессии, +подходящие нейросети

Как говорят, готовь сани зимой, а промты для новогодних ИИ-фотосессий — в ноябре. Картинки можно публиковать уже сейчас...

Miu Miu и New Balance выпустили балетную версию кроссовок 530 SL

Miu Miu и New Balance выпустили балетки на основе 530 SL. От кроссовок модели достались шнуровка, резиновая подошва...

Nvidia «достигла AGI», но никто не знает, что это значит

В среду на отчётной конференции Nvidia Дженсен Хуанг заявил, что компания «достигла AGI» — искусственного общего интеллекта, одной...

Обновлённый Reve: свобода творчества без технических барьеров

Reve представила обновлённую платформу для генерации и редактирования изображений, стремясь сделать визуальное творчество доступным без технических барьеров. Новый...

YouTube запустил генерацию видео с помощью Veo 2 для Shorts

YouTube представил новую функцию для генерации коротких роликов в Shorts, интегрировав ИИ-модель Veo 2 от Google в инструмент...

Google научила Antigravity SDK работать с локальными моделями без интернета

Google научила Antigravity SDK запускать ИИ-агентов на локальных моделях, в том числе без интернета. Первой поддержана открытая Gemma...

Qwen выпустила Qwen-Image-3.0 — модель генерирует сложные макеты и текст от 10 пикселей

Qwen представила Qwen-Image-3.0 — третье поколение модели для генерации и редактирования изображений. Она принимает инструкции объёмом до 4,5...

Gemini 3.8 Live получила видеоаватар для бизнеса

Google выпустила Gemini 3.8 Live with Live Avatar, режим с почти синхронным видеоаватаром для разговорных моделей. Функция доступна...