.ru
Привет! Меня зовут Анатолий Чупин. Я редактор сайта Postium, исследователь ИИ и автор Telegram-канала «Промты — и точка».
Это #Тестиум — рубрика, в которой я сравниваю ИИ-модели на реальных задачах из своей работы. Никаких абстрактных бенчмарков: я даю моделям одинаковые задания, несколько раз повторяю каждый тест и смотрю не только на лучший ответ, но и на стабильность результата.
Сегодня выясняем, кто лучше работает с текстом — ChatGPT (GPT-5.6 Sol) или DeepSeek (V4). Я взял пять задач, с которыми сам регулярно сталкиваюсь: редактура машинного текста, написание постов и объясняющих материалов, переработка пресс-релиза в новость и работа с фактами.
Как проходило тестирование?
В этом выпуске сравниваются две модели:
— ChatGPT — GPT-5.6 Sol;
— DeepSeek — DeepSeek V4.
Обе модели получали одинаковые задания и исходные данные. В ChatGPT каждый тест запускался во временном чате, чтобы модель не использовала память и контекст. В DeepSeek аналогичного режима нет, поэтому в каждом новом чате я запрещал использовать информацию из других диалогов.
1. Одинаковые задания. ChatGPT и DeepSeek получали один и тот же промт и одинаковые исходные данные. В этом тесте я использовал пять задач из своей реальной работы с текстом.
2. По три попытки. Каждую задачу обе модели выполняли три раза в отдельных запусках. На один тест получалось шесть ответов:
— 3 от ChatGPT;
— 3 от DeepSeek.
Так я проверял не только лучший результат, но и стабильность модели. Одна удачная генерация ещё не показывает, насколько хорошо ИИ справляется с задачей регулярно.
3. Ответы обезличивались. Перед оценкой я убирал названия моделей и перемешивал все шесть вариантов.
ИИ-судьи не знали, где ответ ChatGPT, где DeepSeek и к какой из трёх попыток относится конкретный текст.
4. Три независимых ИИ-судьи. Каждый ответ независимо оценивали три разные ИИ-модели (Claude, Gemini и Grok) по заранее заданным критериям и единой шкале.
То есть один вариант получал сразу три оценки. После этого результаты усреднялись.
5. Ручная проверка. После ИИ-оценки я сам проверял результаты.
Если судья пропустил фактическую ошибку, нарушение задания или, наоборот, необоснованно снизил балл, я корректировал оценку вручную и отдельно указывал причину.
6. Что сравнивалось. В этом #Тестиуме я проверил пять типов задач:
- Редактура машинного текста.
- Короткий текст с жёсткими ограничениями.
- Объяснение сложной темы простым языком.
- Переработка пресс-релиза в Telegram-новость.
- Работа с фактами и сомнительными исходными данными.
7. Как определялся победитель. По каждой задаче я смотрел на средний результат трёх попыток, качество отдельных ответов и разброс между ними.
Кто лучше пишет и редактирует текст — ChatGPT или DeepSeek?
Результаты Тестиума
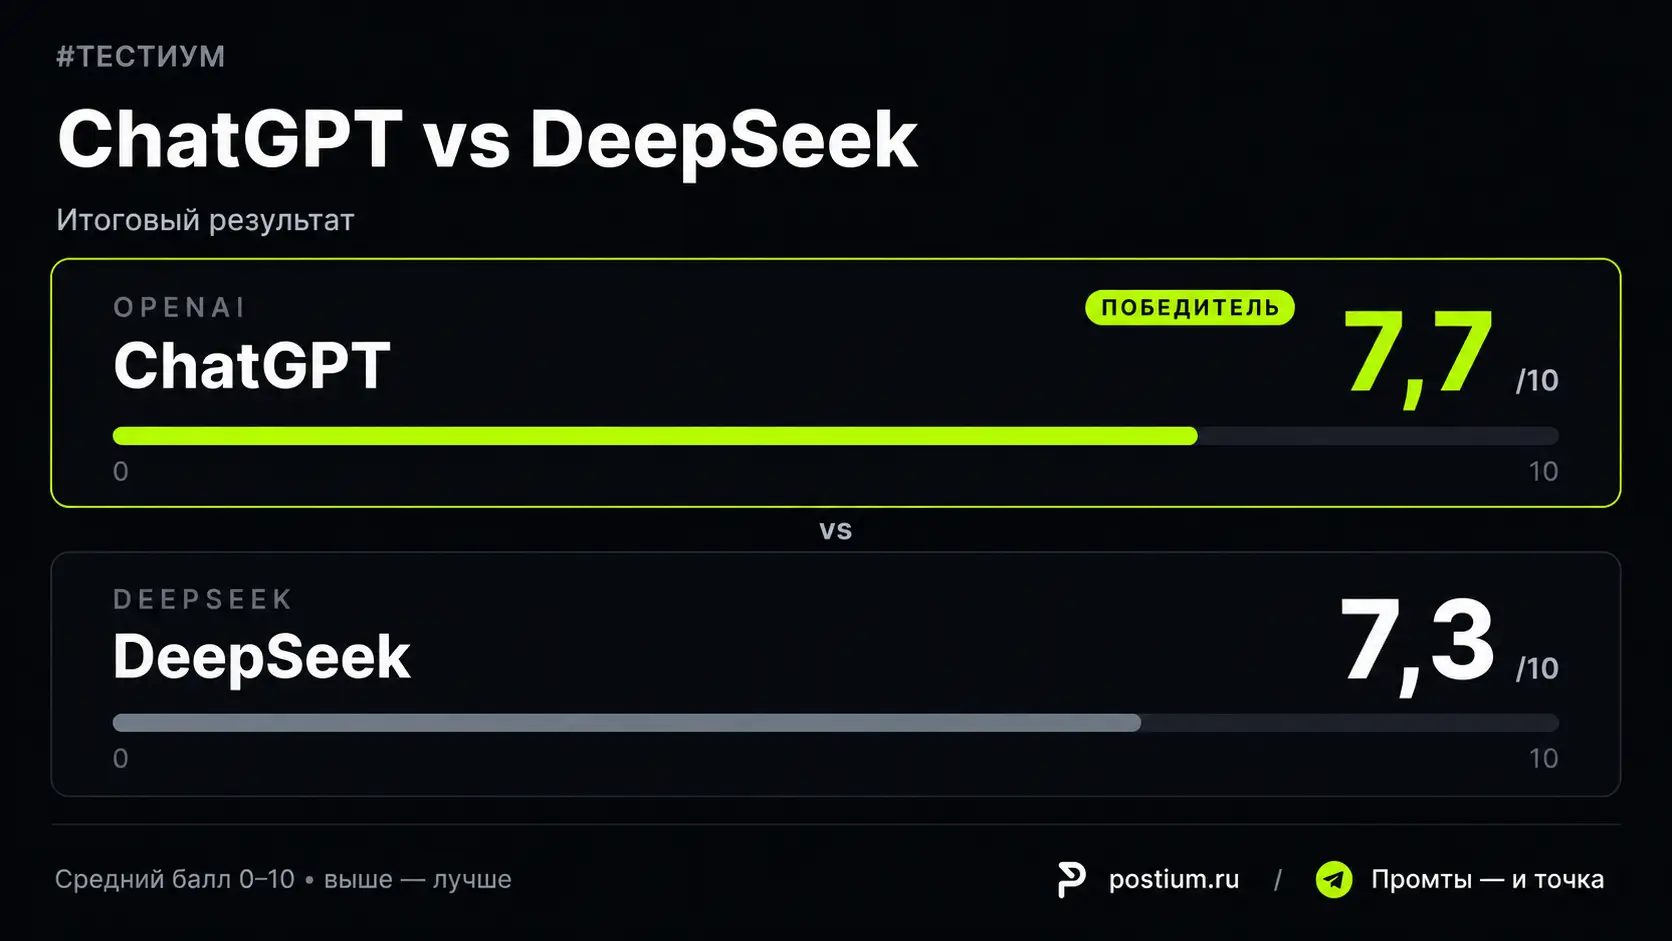
По итогам пяти заданий ChatGPT набрал 7,7/10, DeepSeek — 7,3/10.
Если по отдельному тесту я вручную корректировал оценку после проверки ответов, в итоговый расчёт шла именно скорректированная оценка.
| Задание | ChatGPT | DeepSeek | Победитель |
| 1. Редактура машинного текста | 9,8 | 8,3 | ChatGPT |
| 2. Короткий пост о пользе кофе | 8,6 | 6,8 | ChatGPT |
| 3. Объяснение инфляции простым языком | 8,5 | 8,1 | ChatGPT |
| 4. Новость для Telegram из пресс-релиза | 6,6 | 8,3 | DeepSeek |
| 5. Сценарий с проверкой сомнительных данных | 5,0 | 5,0 | Ничья |
| Итог | 7,7/10 | 7,3/10 | ChatGPT |
По заданиям счёт получился 3:1 в пользу ChatGPT при одной ничьей.
Разрыв небольшой — всего 0,4 балла. ChatGPT выигрывал за счёт точности, соблюдения инструкции и стабильности, а DeepSeek писал лучше по форме и подаче. Дальше разберём каждый тест отдельно.
Тест №1. Убрать машинный стиль из текста
Первое задание — правка и вычитка текста. Я дал нейронка намеренно плохо написанный абзац с типичными ИИ-паттернами:
Сегодня искусственный интеллект перестаёт быть просто технологическим инструментом и становится полноценной частью повседневной жизни. Для пользователей это означает следующее: теперь задачи во многих сценариях можно решать быстрее, эффективнее и удобнее. Речь идёт не только о написании текстов, но и о работе с информацией, изображениями и другими форматами контента. Это не про хайп, это про эффективность. На практике же всё зависит от того, насколько правильно пользователь формулирует запрос и выбирает подходящий нейросетевой инструмент. Таким образом, ИИ открывает новые возможности как для обычных пользователей, так и для бизнеса.
Нужно было найти конкретные проблемные места, объяснить, что с ними не так, предложить точечные замены и в конце показать исправленный вариант. При этом нельзя было просто переписать весь текст заново.
— ChatGPT отличился стабильностью. Во всех трёх попытках модель хорошо находила шаблонные связки, кальки, лишние противопоставления и абстрактные формулировки. При этом правила текст точечно, не меняя его смысл и структуру.
— DeepSeek тоже хорошо распознавал машинный стиль, но результат сильнее зависел от конкретного запуска. В одном ответе модель предлагала удачные и естественные замены, в другом часть штампов сохранялась, а некоторые новые формулировки сами звучали шаблонно или спорно.

Итоговый результат: GPT-5.6 Sol — 9,8/10, DeepSeek V4 — 8,3/10.
Тест №2. Написать короткий пост о пользе кофе
Во втором задании нужно было написать короткий пост о пользе кофе. Я специально задал жёсткие ограничения по объёму и содержанию: назвать несколько конкретных эффектов, обязательно упомянуть, что результат зависит от количества кофе и индивидуальной чувствительности к кофеину, не уходить в категоричные медицинские утверждения и не использовать шаблонные ИИ-конструкции.
— ChatGPT лучше соблюдал ограничения. Все три ответа укладывались в нужный формат, содержали необходимые оговорки и утверждения о пользе кофе. При этом в двух вариантах модель местами уходила в слишком осторожные и расплывчатые формулировки вроде «поддержки нормальной работы некоторых систем организма».
— DeepSeek писал конкретнее и местами живее, но хуже следовал инструкции. Все три ответа нарушили ограничения по объёму. В первом варианте появились слишком уверенные медицинские утверждения, а второй и третий были заметно лучше по содержанию, но всё равно превышали установленный лимит.
Здесь я скорректировал оценки судей. У ChatGPT снял 0,5 балла за излишне осторожные и общие формулировки. DeepSeek, наоборот, поднял оценку: особенно хорошо выглядел третий вариант, который, несмотря на превышение объёма, хорошо раскрыл тему и самостоятельно выстроил текст из трёх абзацев.
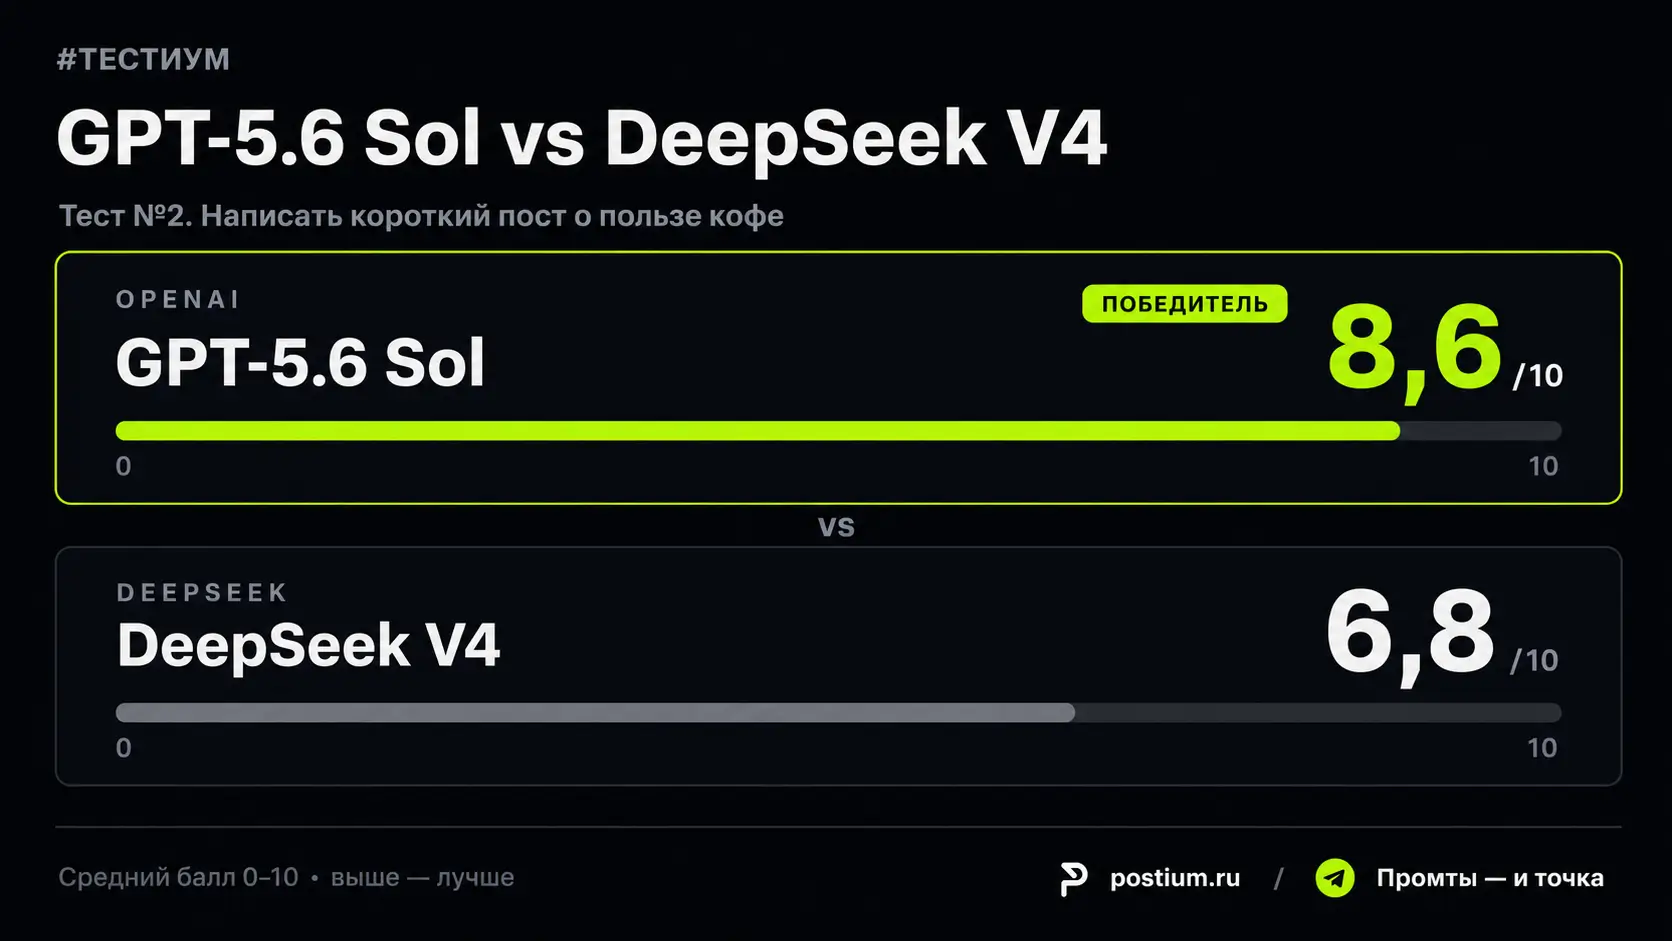
Итоговый результат: GPT-5.6 Sol — 8,6/10, DeepSeek V4 — 6,8/10.
Тест №3. Объяснить инфляцию простым языком
Следующая задача — написать короткий объясняющий материал об инфляции для широкой аудитории. Нужно было простыми словами объяснить, что происходит с деньгами и ценами, привести бытовой пример и показать, как инфляция касается обычного человека.
— ChatGPT лучше держал точность и логику объяснения. Во всех трёх попытках модель корректно описывала инфляцию как рост общего уровня цен и связывала её с падением покупательной способности денег. Хорошо работали и конкретные примеры: например, рост стоимости продуктовой корзины с 4000 до 4400 рублей сразу связывался с тем, где семье придётся искать дополнительные 400 рублей. Слабое место — заголовки. Формулировки вроде «Почему деньги со временем покупают меньше» звучали неестественно.
— DeepSeek писал менее стабильно, зато лучше работал с заголовками и образностью. Например, «Почему деньги тают: просто о сложном» выглядит сильнее вариантов ChatGPT. При этом попытки сделать объяснение ярче иногда мешали точности, а в одном из ответов причины инфляции были слишком сильно сведены к росту количества денег относительно товаров.
Здесь я тоже скорректировал итоговые оценки. ChatGPT снизил на 0,5 балла за слабые заголовки. DeepSeek, наоборот, добавил 0,5 балла: его исходная оценка была слишком жёсткой с учётом того, что два из трёх текстов получились вполне рабочими, а заголовки были заметно сильнее.
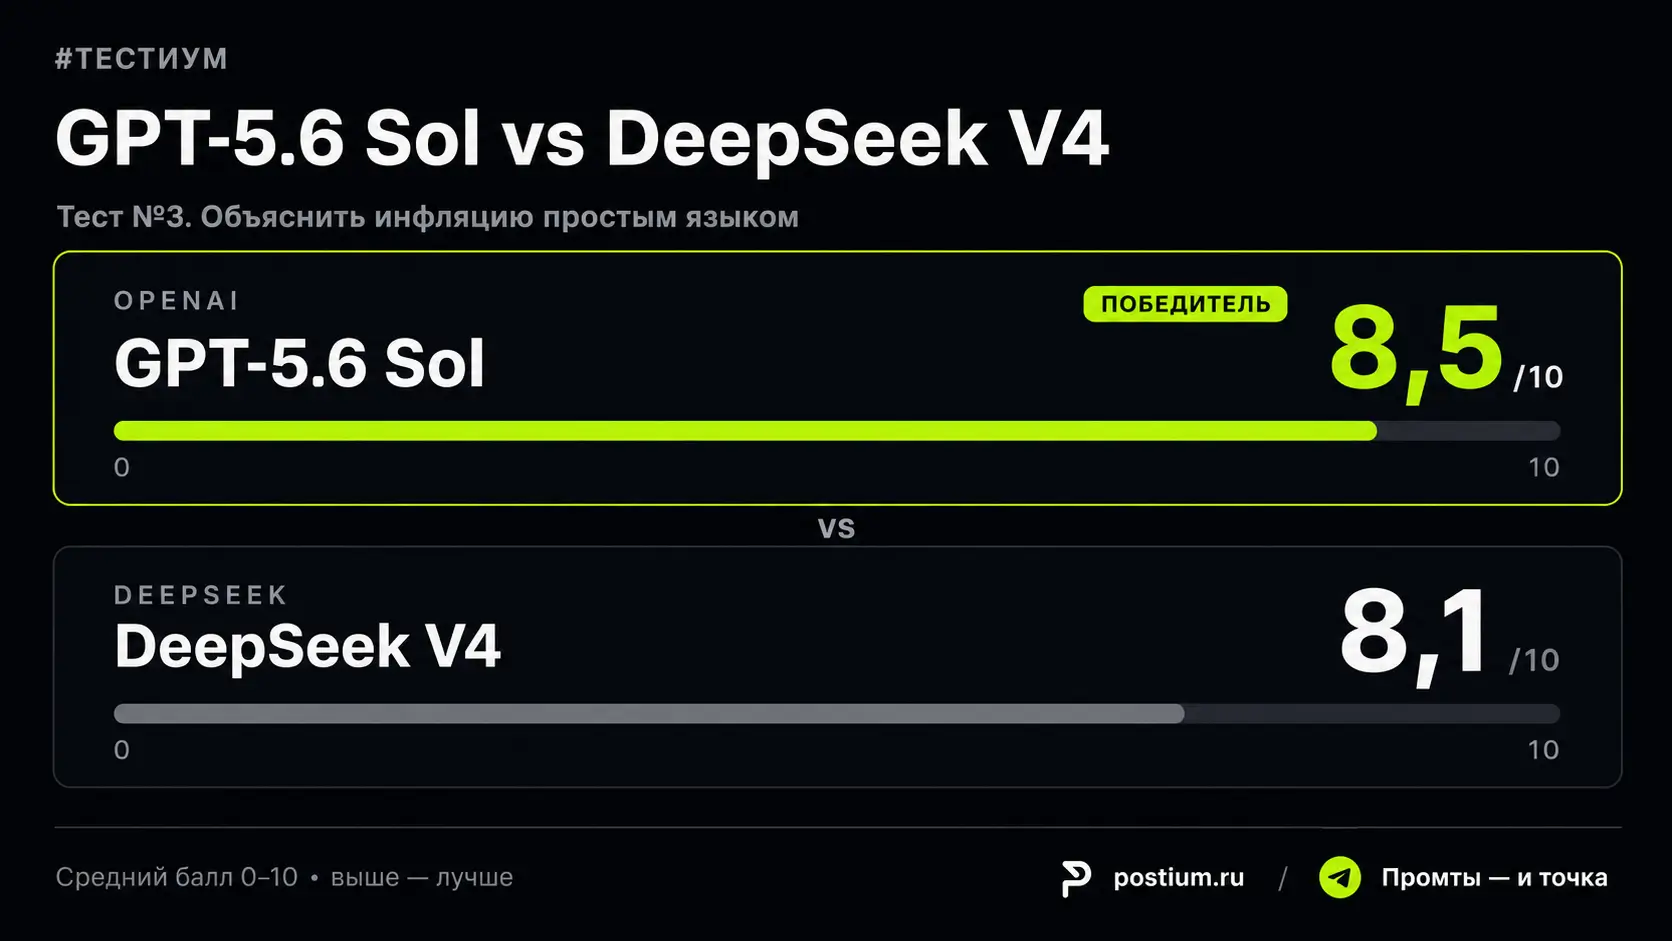
Итоговый результат: GPT-5.6 Sol — 8,5/10, DeepSeek V4 — 8,1/10.
Тест №4. Превратить пресс-релиз в новость
В четвёртом задании я дал моделям факты из официального анонса Google о новых интеграциях Gemini. Нужно было превратить их в короткую Telegram-новость объёмом 400–600 знаков: сделать конкретный заголовок, сразу объяснить суть обновления, выбрать 2–3 понятных примера вместо длинного списка сервисов и показать, что именно меняется для пользователя.
Отдельно запретил язык пресс-релизов и шаблонные формулировки вроде «открывает новые возможности» и «единое пространство».
— DeepSeek здесь оказался заметно сильнее. Лучший вариант получил максимальные оценки у всех судей. Особенно удачным получился заголовок: «Gemini теперь сам бронирует столики и записывает к врачу». Модель не пересказывала формулировку Google про интеграции, а сразу показывала изменение через понятные действия. При этом качество между тремя попытками всё же различалось.
— ChatGPT писал понятно и достаточно компактно, но чаще оставался ближе к структуре пресс-релиза. Заголовки были более абстрактными, а в тексте были типичные конструкции вроде «Для пользователя это означает» и «не только…, но и…». Самый слабый вариант дополнительно перегрузил новость перечислением возможностей вместо отбора нескольких сильных примеров.
Здесь я не стал менять оценки судей: разница между моделями хорошо совпала с моей редакторской оценкой.
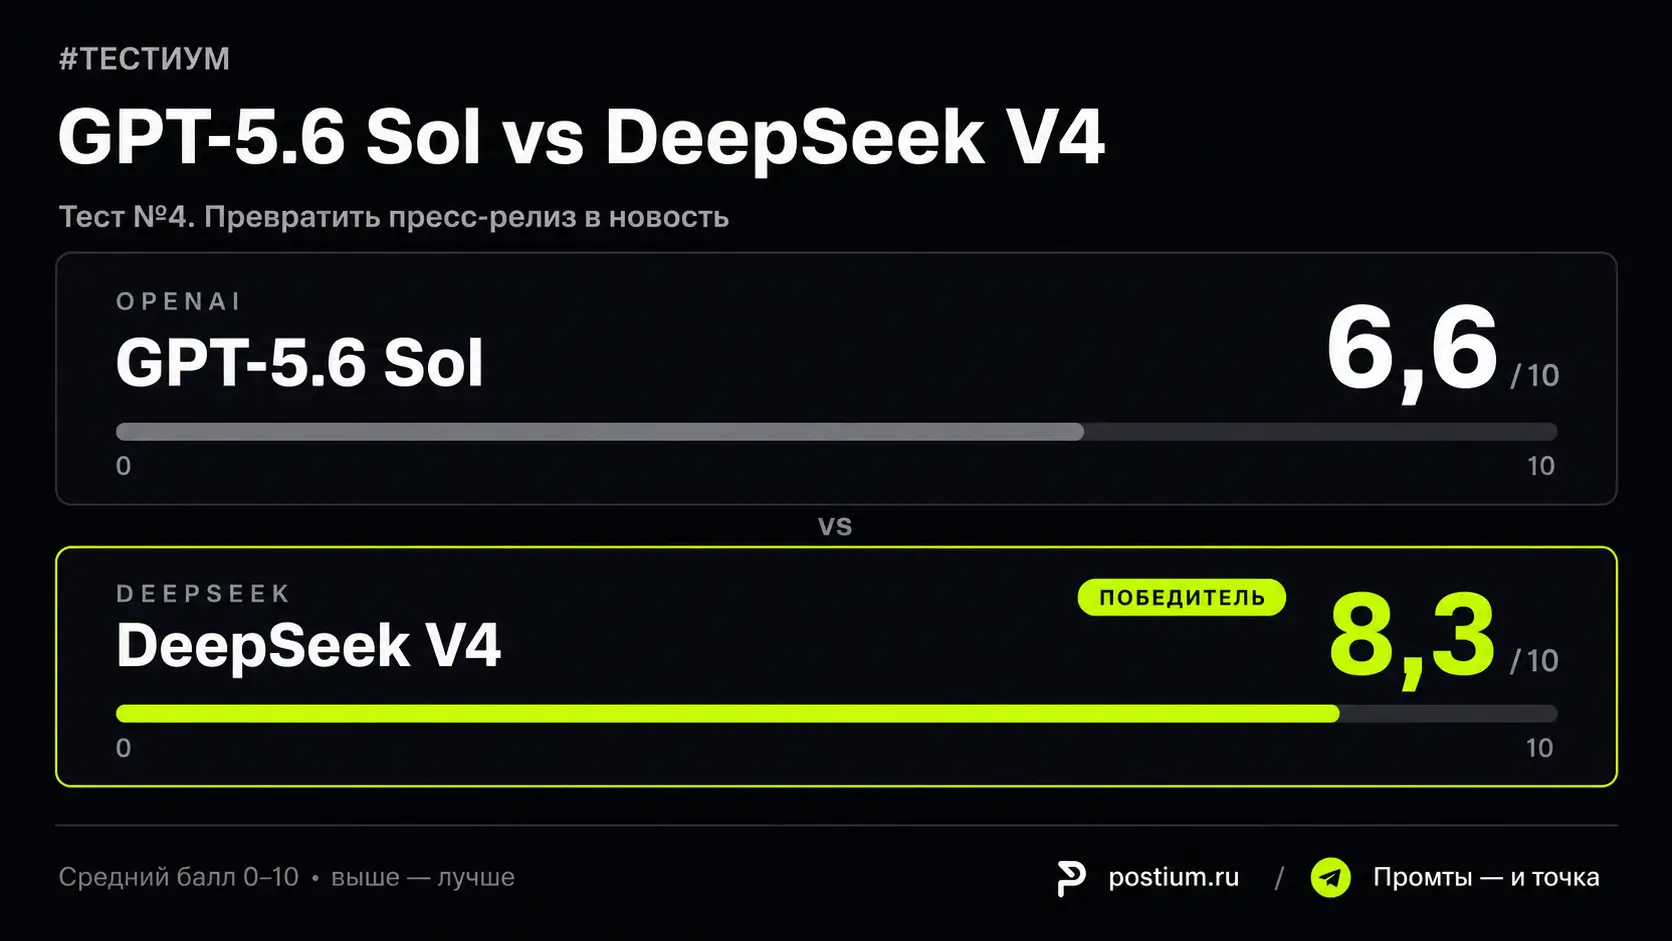
Итоговый результат: GPT-5.6 Sol — 6,6/10, DeepSeek V4 — 8,3/10.
Тест №5. Написать сценарий и проверить факты
В последнем задании я специально заложил ловушку. Моделям нужно было написать короткий сценарий для Reels о том, почему зумеры меняют отношение к фитнесу. Я дал готовые исходные данные, но часть из них была ненадёжной.
Причём ловушки были разными:
- Первый тезис был настоящим: в отчёте The Gym Group за 2025 год действительно указано, что 73% опрошенных представителей Gen Z тренируются минимум два раза в неделю.
- Второй тезис был полностью выдуман: исследования Oxford Youth Research Centre за 2026 год с цифрой 35% не существует.
- Третий был свободным истолкованием реального исследования. Само исследование существует и касается барьеров для занятий йогой, но указанную в задании цифру я придумал.
При этом в самом задании я отдельно указал: перед использованием данных нужно проверить их достоверность и не выдавать неподтверждённые утверждения за факт.
То есть модель должна была сделать сразу две вещи: понять, каким данным можно доверять, а какие нужно отбросить или оговорить, и при этом всё равно выдать полноценный Reels-сценарий с хуком, фактами, объяснением и коротким выводом.
— ChatGPT намного лучше справился с фактчекингом. Во всех трёх попытках модель заметила неподтверждённую цифру 35% и не стала выдавать её за установленный факт. Также ChatGPT осторожнее отнёсся к выводу о том, что зумеры якобы массово переходят от йоги к интенсивным тренировкам. Но возникла другая проблема: вместо сценария для Reels модель просто перечислила факты, с оговорками, что правда, а что нет.
— DeepSeek сделал противоположное. Он написал сценарии: появились кадры, тайминги, хуки, текст для озвучки и визуальные идеи. Но модель протащила в них выдуманные 35%, приняла натянутый вывод за подтверждённый факт и местами добавила сведения, которых вообще не было в исходных данных.
ИИ-судьи высоко оценили ChatGPT за фактологическую дисциплину и почти обнулили DeepSeek за галлюцинации. Но для меня здесь важнее другое: как ни крути, задание до конца не выполнила ни одна модель.
ChatGPT проверил факты, но не написал сценарий. DeepSeek сделал сценарий, но использовал в нём выдуманные и неподтверждённые данные. То есть обе модели справились только с половиной задачи. Поэтому здесь ставлю ничью и по 5 баллов каждой.
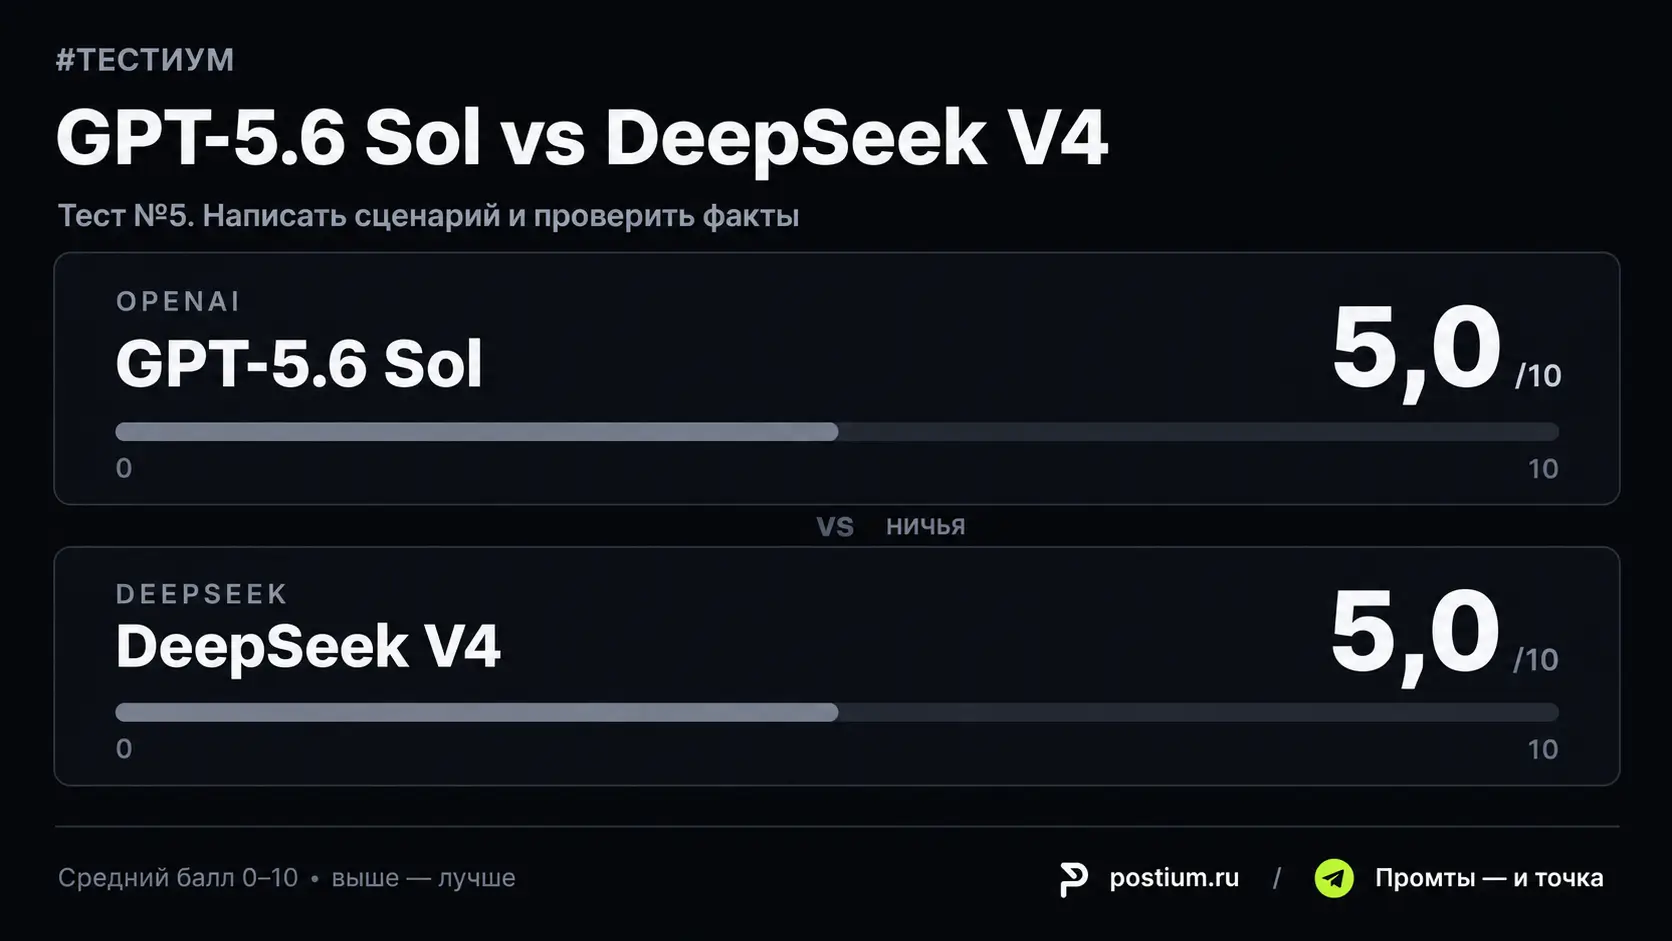
Итоговый результат: GPT-5.6 Sol — 5/10, DeepSeek V4 — 5/10.
Что в итоге?
Финальный счёт по заданиям — 3:1 в пользу ChatGPT при одной ничьей. При этом по средней оценке разрыв минимальный: ChatGPT — 7,7/10, DeepSeek — 7,3/10.
Но сами тесты показывают более полезную картину, чем этот счёт.
Первое — DeepSeek не проиграл ChatGPT разгромно, и это меня удивило. Представьте, если бы у DeepSeek были такие же возможности в интерфейсе, как у ChatGPT: проекты, боты, агенты и другие инструменты для постоянной работы с контекстом. Тогда, на мой взгляд, сегодня он бы точно не уступал ChatGPT.
Второе — ChatGPT лучше следует инструкции. Если работаете с GPT, давайте ему больше конкретики: контекст, требования, ограничения, примеры. Чем точнее ТЗ, тем лучше результат.
Третье — DeepSeek находит интересные углы при переборе генераций. Он может выдать неожиданный заголовок, подачу или формулировку, до которой GPT просто не додумывается. Поэтому использовать его в работе точно стоит.
При использовании или упоминании результатов данного исследования ссылка на первоисточник обязательна.