• Виктор
  • Блог
  • 2 мин. чтения

DeepSeek выпустила V4.1 Flash — открытую ИИ-модель с контекстом до 1 млн токенов


DeepSeek выпустила DeepSeek V4.1 Flash и открыла веса модели на Hugging Face. Она принимает текст и изображения, отвечает текстом и поддерживает контекст до 1 млн токенов.

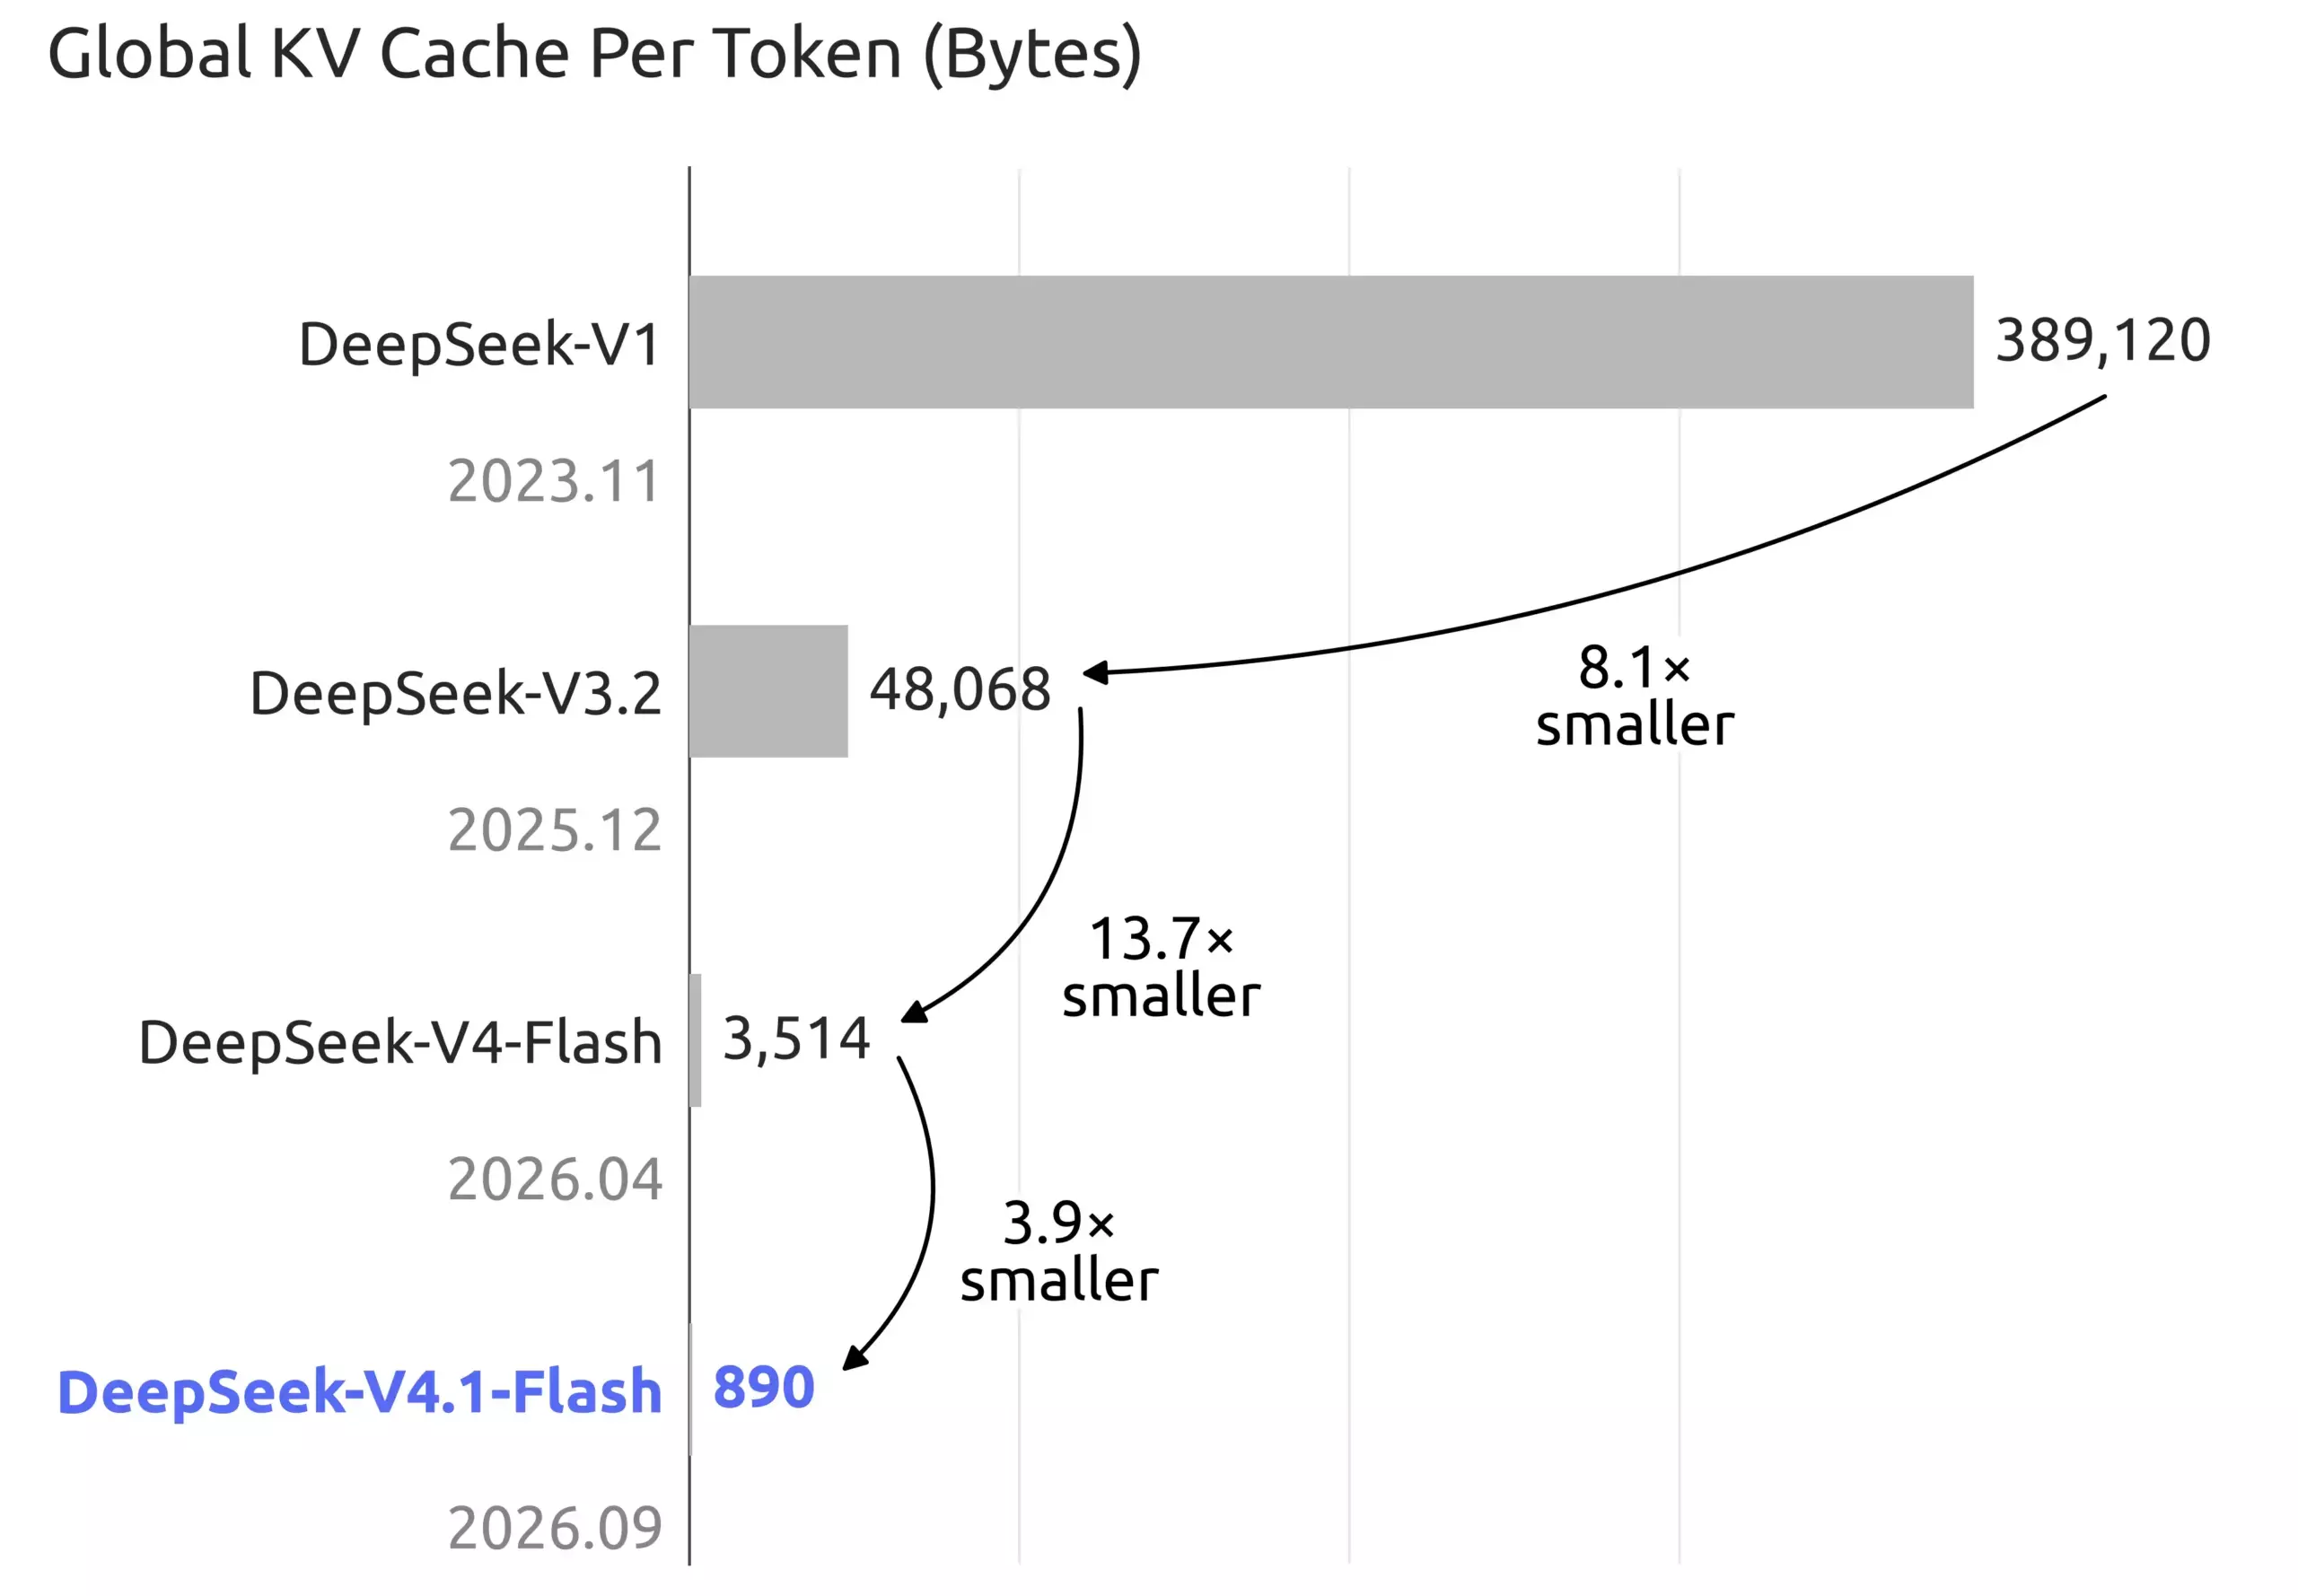
Главное отличие от DeepSeek V4 Flash — новая архитектура и более компактная память для длинных запросов. Глобальный KV-кэш занимает 890 байт на токен — примерно в четыре раза меньше, чем у предыдущей Flash-модели.

Нейросеть DeepSeek V4.1 Flash: что умеет и как работает

В основе модели — 552 млрд параметров. Дополнительно архитектура использует 196 млрд параметров Engram — отдельного механизма памяти, который обращается к данным разреженно. При обработке входных данных модель задействует 8 млрд параметров на токен, а при генерации ответа — 16 млрд. Такой подход сокращает вычисления: модель не использует всю сеть для каждого фрагмента запроса.

Архитектура состоит из 40 слоёв: 20-слойного causal encoder и 20-слойного decoder. Декодер получает уже подготовленные состояния из энкодера и не создаёт отдельный полный кэш на каждом слое. Дополнительное сжатие и повторное использование данных уменьшают расход памяти при работе с большими документами и длинными цепочками действий.
DeepSeek V4.1 Flash можно передавать текст и изображения в одном запросе, в том числе чередовать их внутри диалога. Модель анализирует визуальные и текстовые данные вместе, но выдаёт только текст.

Разработчики также добавили числовую настройку глубины рассуждения от 1 до 100. Чем выше значение, тем больше вычислений модель тратит на ответ. Параметр позволяет отдельно настраивать быстрые запросы и сложные задачи с инструментами.

Что показали тесты DeepSeek на бенчмарках

DeepSeek проверяла модель при максимальной глубине рассуждения (reasoning_effort=100) и контексте до 1 млн токенов. В DeepSWE v1.1 она решила 74,2% задач против 54,4% у DeepSeek V4 Flash. В Terminal-Bench 2.1 результат вырос с 82,7% до 90,6%.

Компания также сравнила разные оболочки для программирующих агентов. В DeepSWE v1.1 лучший результат модели составил 74,2% с mini-SWE-agent (выше, чем у Claude Opus 5 и GPT-5.6 Sol), а в Terminal-Bench 2.1 — 90,6% с минимальной оболочкой DeepSeek Harness.

Как получить доступ

Скачать веса DeepSeek V4.1 Flash и код для самостоятельного запуска можно на странице модели на Hugging Face. Репозиторий распространяется по лицензии MIT. Для запуска доступны инструкции для Transformers, vLLM, SGLang и Docker. Модель также доступна через API DeepSeek.

Ранее писали, что DeepSeek прокачала V4-Pro — она получила контекстное окно на 1 млн токенов, максимальный объём ответа до 384 тыс. токенов и управление глубиной рассуждений через API.

Источник / изображения: huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash


Источник

Где попробовать
Claude, GPT, Gemini и ещё 300 моделей — в одном окне
Умка даёт доступ к нейросетям на русском и за рубли: без VPN и зарубежных карт. Текст, картинки, видео и музыка — в одном интерфейсе. На пробу 60 токенов, карта не нужна.
Открыть Умку бесплатно
Межтекстовые Отзывы
Посмотреть все комментарии
guest

Google анонсировала Pics — ИИ-редактор для работы с изображениями

Google анонсировала Pics — новый инструмент для генерации и редактирования изображений в Google Workspace. Он работает на базе...

Suno выпустила бесплатную модель «v4.5-all» — нейросеть создаёт топовую музыку и вокал

Нейросеть Suno AI официально заменила старую модель «v3.5» на более новую «v4.5-all» в бесплатной версии сервиса. Теперь пользователи...

OpenAI выпустила GPT Image 2 и ChatGPT Images 2.0

OpenAI представила GPT Image 2 для API и одновременно обновила генерацию изображений в ChatGPT до версии Images 2.0....

Perplexity открыла исходный код Lily — движка для локальной работы ИИ на Mac

Perplexity открыла исходный код Lily — лёгкого движка инференса для локальной работы с моделями в Perplexity Computer. Он...

Сверхработоспособный Qwen 3.7 Max. Китайский ИИ, который трудится 35 часов без остановки

Среди всего того, что Alibaba представила на своем облачном саммите в мае 2026 года, флагманская языковая модель Qwen...

Kling представила Avatar 2.0 — длина видео до 5 минут, «чистый» липсинк и «живая» мимика 

Разработчики Kling AI (Kuaishou) выпустили модель Avatar 2.0 — обновление инструмента для создания говорящих цифровых аватаров. Релиз состоялся...

YouTube позволит генерировать Shorts с помощью Veo 3

На мероприятии «Made on YouTube» 16 сентября компания представила большое обновление для Shorts и YouTube Studio. В сервис...

DeepSeek представила DeepSeek-OCR — новую модель для сжатия визуального контекста в LLM

Компания DeepSeek показала DeepSeek-OCR — OCR-модель, созданную специально для больших языковых моделей. Вместо обычного распознавания текста она сжимает...

Alibaba сообщила о падении прибыли на 75% из-за крупных инвестиций в ИИ-инфраструктуру

Китайский технологический гигант Alibaba в четверг сообщил о падении прибыли за последний квартал на 75% на фоне крупных...

OpenAI выпустила приложение Sora на Android — пока только в 7 странах

OpenAI представила Android-версию приложения Sora — инструмента для генерации коротких видео с помощью искусственного интеллекта. Скачать ИИ-генератор видео...

Luma Labs представила модель Uni-1 которая думает и рисует одновременно

Luma Labs представила Uni-1 - первую генеративную модель, которая объединяет мышление и создание изображений в одном процессе. Система...

ImagineArt показала модель 2.0

ImagineArt представила модель ImagineArt 2.0 и делает ставку на то, что в генерации изображений пользователям важен уже не...

Вышла Kling Video 3.0 — ИИ-модель для генерации видео из нескольких сцен

Kuaishou выпустила Kling Video 3.0 — новую версию своей модели для генерации видео. Ключевое изменение — теперь ролик...

Google научила Antigravity SDK работать с локальными моделями без интернета

Google научила Antigravity SDK запускать ИИ-агентов на локальных моделях, в том числе без интернета. Первой поддержана открытая Gemma...

Google выпустила Nano Banana 2 Lite и Gemini Omni Flash

30 июня Google открыла доступ к двум новым моделям генеративной графики и видео - Nano Banana 2 Lite...

Google запустила Pics — ИИ-редактор изображений на базе Nano Banana

Google начала постепенно открывать доступ к Google Pics — новому ИИ-редактору изображений для Google Workspace на базе модели...

GLM 5.3: мощнее в коде и кибербезопасности

14 августа 2026 года уже упоминавшаяся нами в предыдущих обзорах компания Zhipu AI представила следующую версию своей флагманской...

Google выпустила Nano Banana 2 Lite — быструю модель для генерации изображений через Gemini API

Google выпустила Nano Banana 2 Lite (gemini-3.1-flash-lite-image) — новую модель для генерации и редактирования изображений. Это самая быстрая...

ElevenLabs добавила генерацию речи, музыки, изображений и видео в MCP

ElevenLabs расширила свой MCP-сервер. Теперь подключённый ИИ-ассистент может создавать речь, музыку, звуковые эффекты, изображения и видео, а также...

Как пользоваться QwenWork: регистрация, возможности, бесплатные кредиты и тарифы

QwenWork — это новый ИИ-агент от Alibaba, который доступен на сайте и через отдельное приложение. По принципу работы...