.ru
Gemini Omni 1.1 Flash — видеомодель Google для разработчиков, которую компания предлагает встраивать в редакторы и генераторы роликов. Обновление подаётся не как скачок в качестве картинки, а как набор рычагов управления: чем снимает виртуальная камера, что происходит между двумя кадрами, сколько длится сцена. Модель вышла из тестового статуса и работает в производственном режиме.
Сорок секунд из четырёх кусков
За одну генерацию Gemini Omni 1.1 Flash по-прежнему выдаёт десять секунд. Новое — возможность продолжить готовый фрагмент ещё одним десятисекундным куском, и так до сорока секунд общей длительности.
Опробовать её вместе с GPT, Claude и Gemini можно там же, где собраны нейросети на русском за рубли.
Работает это заметно аккуратнее прежнего. Раньше модель при продолжении смотрела только на последнюю секунду ролика, теперь берёт в расчёт до десяти секунд предыдущего материала. Именно на стыках генеративное видео обычно и рассыпается — герой меняет куртку, свет прыгает, интерьер перестраивается.
Ключевые кадры вместо длинных описаний
Второй рычаг — генерация по двум опорным кадрам. Разработчик задаёт первый и последний кадр, а Google достраивает то, что между ними: наезд, облёт объекта, разворот камеры, бесшовную петлю для фона. Сложные операторские движения вроде резкой панорамы или наезда с одновременным отъездом объектива модель отрабатывает по описанию.
К этому добавили визуальные референсы. На вход принимается до трёх видеофрагментов длиной до трёх секунд каждый — по ним модель удерживает внешность персонажа, стиль и вид товара. Раскадровка перестаёт быть текстовым упражнением, где нужную картинку выпрашивают формулировками.
Цена спустилась до уровня Alibaba
Для перебора вариантов появился режим 360p. Google обещает генерацию до 60% быстрее стандартного 720p и примерно треть его цены. Секунда 720p обходится около $0,10, считается она по токенам — 5792 токена на секунду ролика.
Про цену 1080p и 4K в анонсе не сказано ничего. Оба разрешения получаются апскейлом, тарифицируются те же токены, но во сколько раз дороже выйдет чистовик в 4K, компания отдельной строкой не показала. Для продукта, который продают студиям и редакторам, это неудобный пробел.
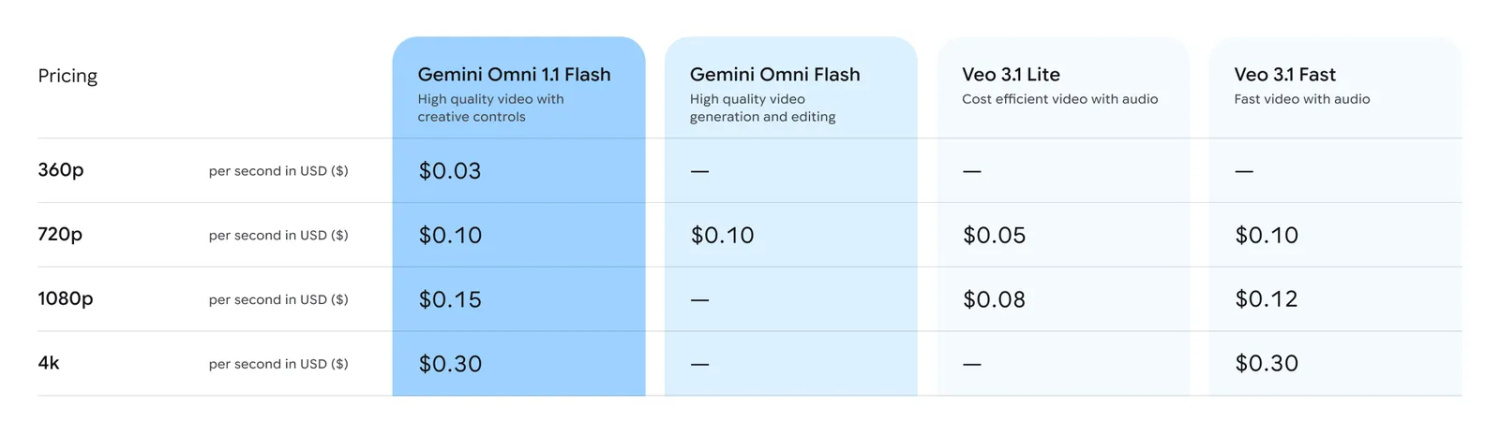
Google Veo 3.1 просит около $0,40 за секунду. Gemini Omni 1.1 Flash в стандартном качестве стоит вчетверо меньше и ровно столько же, сколько Alibaba берёт за 720p у Wan3.0, — ценовой паритет с китайским конкурентом Google держит впервые за год.
По длине ролика расклад другой. Wan3.0 выдаёт 30 секунд за одну генерацию без склейки, ByteDance в Seedance 2.5 — те же 30 секунд сразу в 4K. Сорок секунд Gemini Omni собираются из четырёх кусков, и это компромисс, а не рекорд. Зато поле Google освобождают сами конкуренты. Sora у OpenAI доживает последние недели, приложение закрыли ещё весной, API отключают в сентябре.
Лица и надписи всё ещё плывут
Слабые места Google не прячет. Согласованность персонажа при последовательных правках и текст в кадре остаются нерешёнными задачами — те же грабли, на которые публично наступила Alibaba с Wan3.0. Работа со звуком и речью придержана. Доступ к редактированию аудио Google открывает осторожно, пока обкатывает правила ответственного выпуска.
Потолок в сорок секунд тоже стоит держать в голове. Это четыре последовательных обращения к API, четыре точки, где сцена может уехать, и оплата каждой генерации отдельно.
Где включили и кто уже встроил
Разработчикам модель доступна в Google AI Studio и через Gemini API, корпоративным клиентам — через API платформы Gemini Enterprise. В Flow, видеоредакторе Google, она открыта подписчикам планов AI Plus, Pro и Ultra. Продолжение сцен добавили и в обычное приложение Gemini, там рычагов меньше, но попробовать механику можно без кода.
Из внешних продуктов модель уже подключили Adobe в Firefly, Figma в редакторе Weave и Runway , плюс несколько облачных провайдеров. Набор подобран под одну ставку. Google продаёт Gemini Omni тем, кто делает инструменты для монтажёров, а не конечному зрителю.
Черновики в 360p, чистовик в 1080p
Тем, кто делает ролики для сайтов и соцсетей, Gemini Omni 1.1 Flash меняет порядок работы. Идеи перебираются в 360p, пока не сойдётся композиция и движение камеры, и только потом оплачивается чистовая генерация. Черновой режим стоит треть обычного, поэтому десяток проб выходит дешевле одного неудачного финала.
Вторая привычка — короткие фоновые петли через первый и последний кадр. Одинаковые опорные кадры дают зацикленный ролик без видимого стыка, и такой фон в шапку страницы генерируется за секунды.
Гонка ушла из качества в управляемость
Заявку Gemini Omni 1.1 Flash стоит проверять на длинных сценах. Если четыре сшитых куска действительно держат лицо героя и свет, у рекламных студий пропадает главный довод против генеративного видео. Если на третьем стыке картинка поедет, сорок секунд останутся цифрой из пресс-релиза, а рабочим форматом — те же десять.